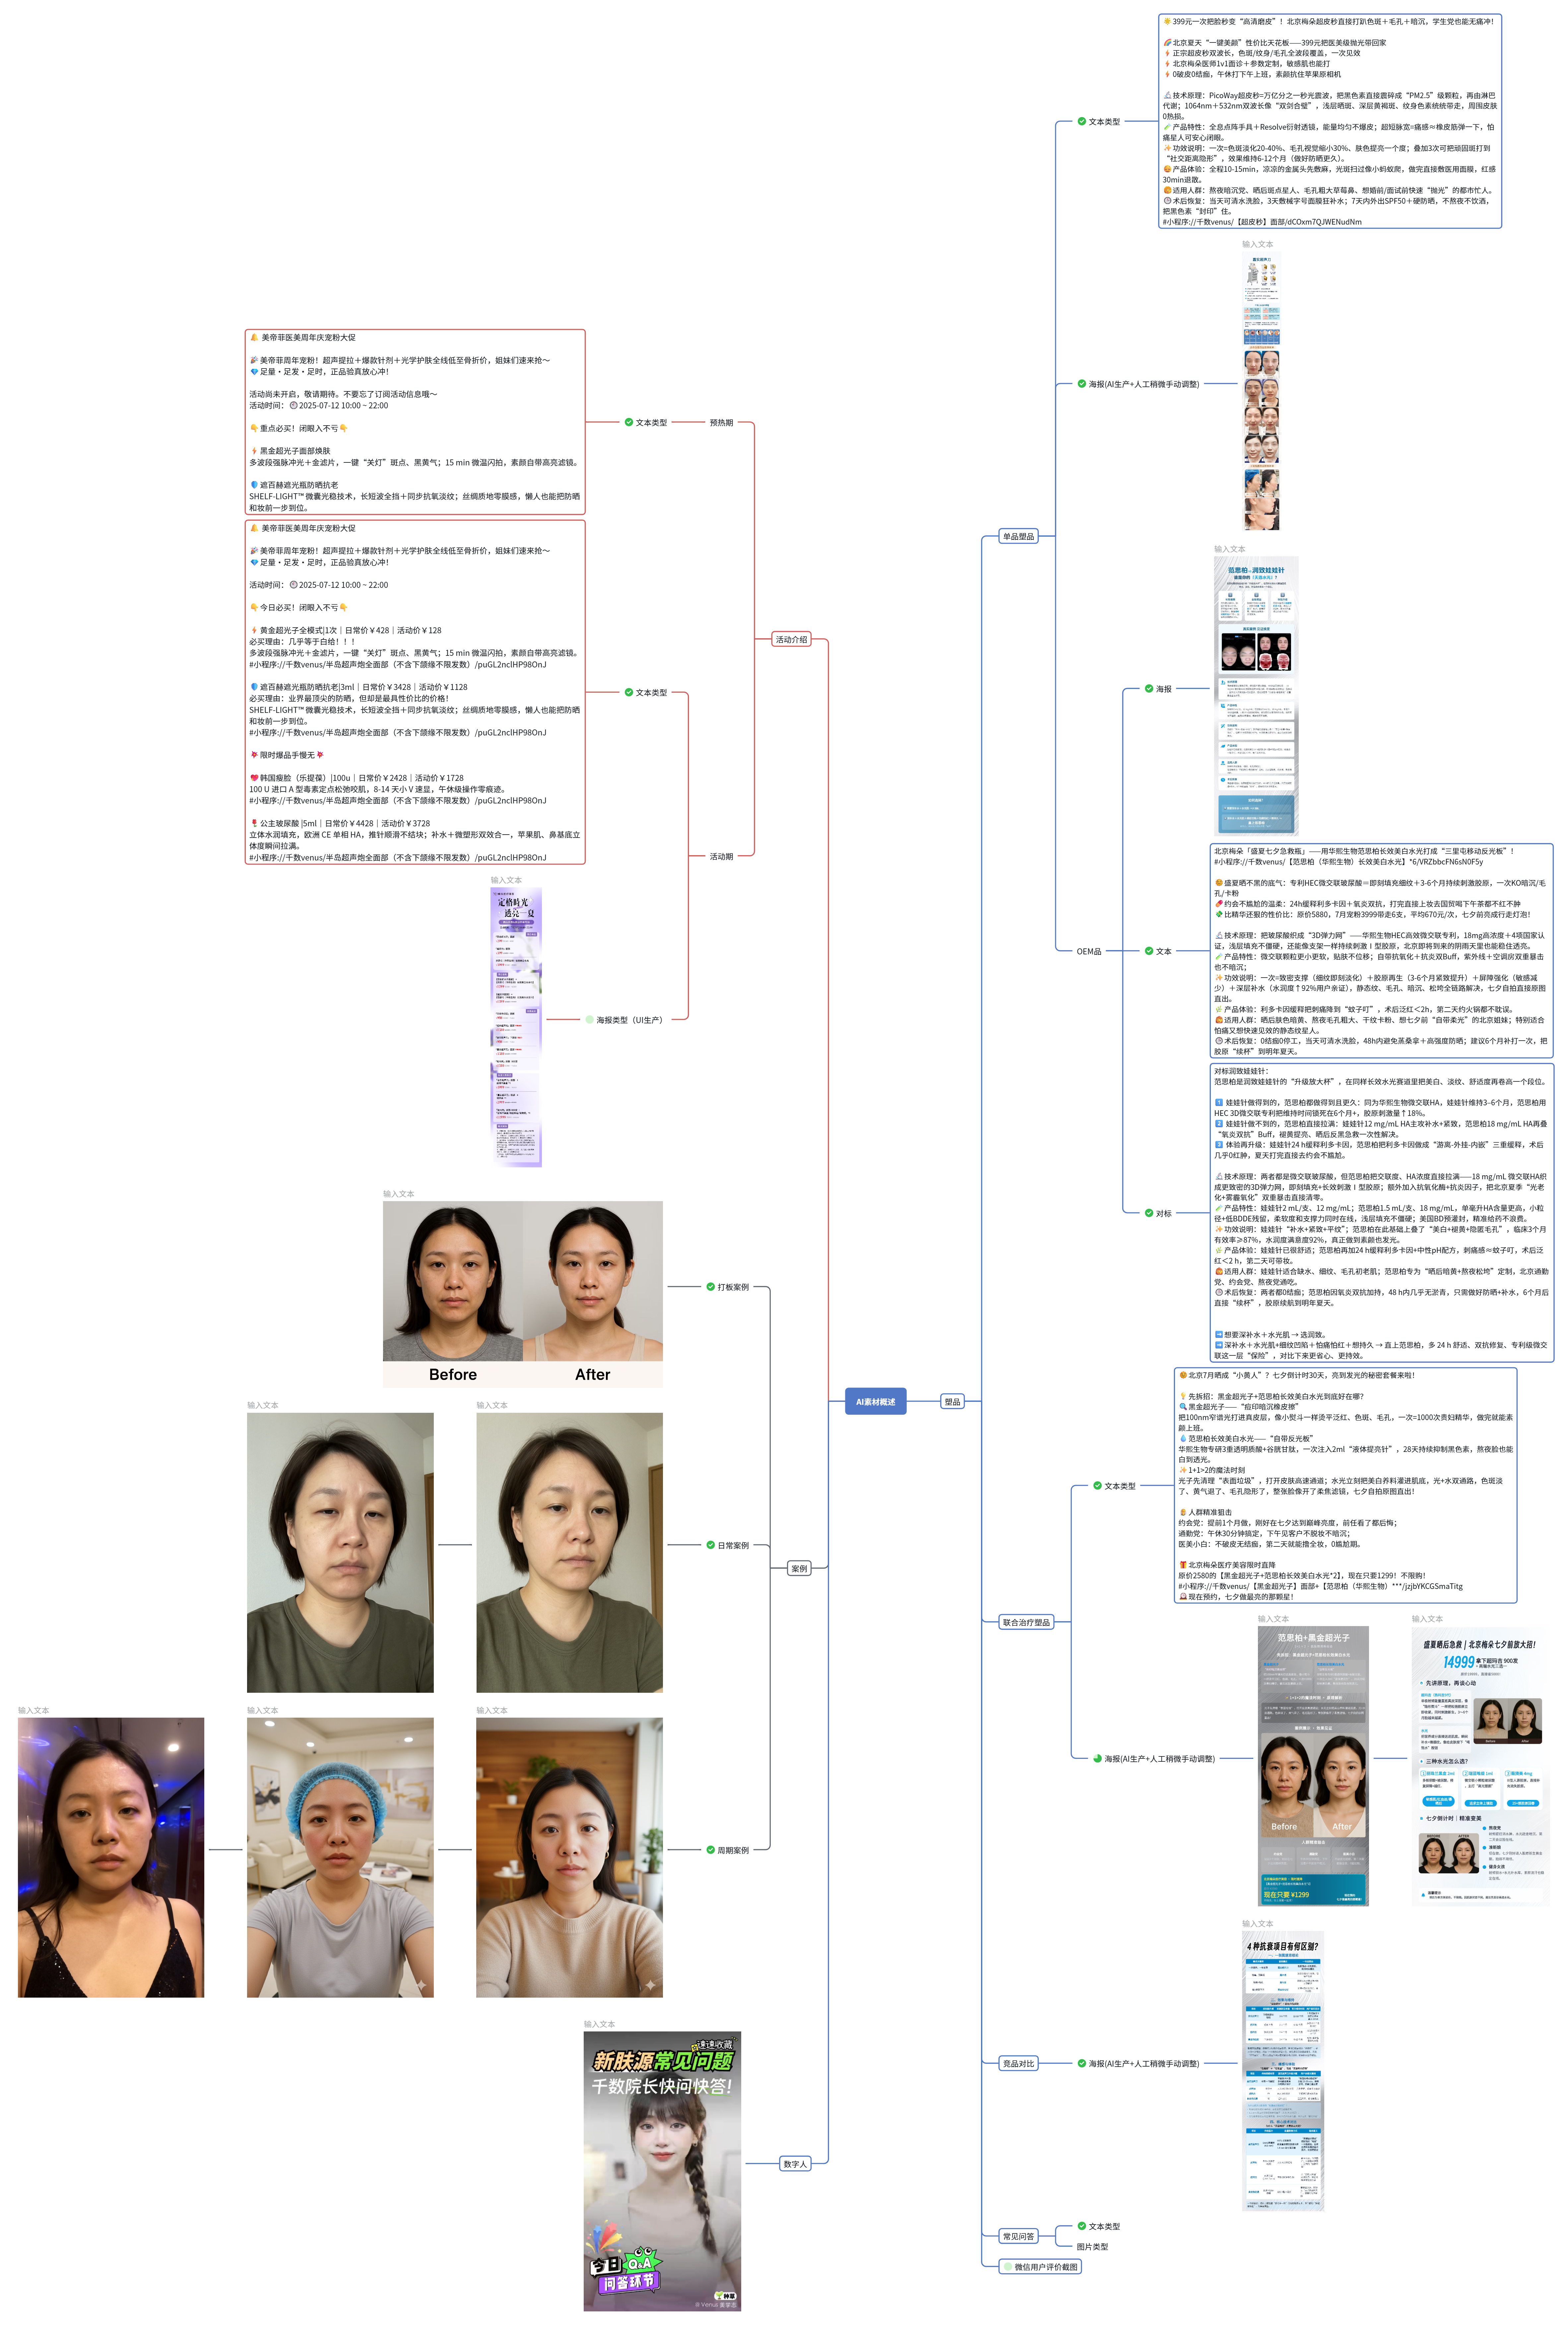
先放一张当时的素材全景图,点开可以看原图。里面的案例对照是 AI 生成示例,图内历史营销话术也仅用于回看项目。
前面写过 AI 美学报告,这次聊聊另一个做起来很碎、但离业务很近的项目:用 AI 给医美产品做一整套营销素材。
医美产品推新的速度越来越快,OEM 品也越来越多。站在用户的角度,一个产品到底有什么特点,和另一个名字很像的产品差在哪,适不适合自己,要弄明白并不轻松。
机构也有自己的难处。新品到了,咨询师要推荐,朋友圈要发,活动要预热,客户问起来还得有东西可以解释。产品资料可能只有一份介绍,剩下的全靠院内人员自己整理、找图、写文案、催设计。
新氧连锁的产品包装给过我挺直接的启发:包品做好了,确实能带来客户和订单。但背后是一个部门花很长时间去做。普通机构很难拿出同样的人力,素材生产最后经常卡在院内几个人的时间和能力上。
所以当时想做的事情很明确:围绕一个产品,把案例、海报、文案、视频这些东西配齐,交给机构人员,在自己的私域里接着用。
从产品经理的角度,我需要先把“配齐”拆清楚。哪种素材解决什么问题,什么内容可以共用,哪里必须换一种讲法,这些定义会直接决定后面的工作流。
一、先把素材类型拆开
最后整理下来,主要是六类。
| 素材类型 | 主要解决的问题 | 典型形式 |
|---|---|---|
| 案例 | 帮用户理解关注部位和外观变化的表达 | 打板、日常、周期、局部 |
| 产品海报 | 把产品特点和选择理由讲清楚 | 活动、朋友圈、单品、OEM、联合治疗、对比、问答 |
| 宣传文案 | 让机构人员拿到文字就能继续沟通 | 活动预热、朋友圈介绍、产品解释、常见问答 |
| 数字人 | 把内容变成可以观看和转发的视频 | 单人口播、问答、面诊 |
| 小红书软文 | 用具体场景组织产品内容,测试内容吸引力 | 人群选题、图文组合、系列内容 |
| 客户评价图 | 整理已有反馈,或演示对话式内容版式 | 真实反馈整理、明确标注的模拟对话 |
同一个产品,第一次出现时需要让人愿意看,客户追问时需要把细节说清楚,活动期间又要把时间、价格和参与方式说明白。素材的使用场景不同,内容结构自然也不同。
这也是我觉得这个项目有意思的地方。看上去是生成一堆图,往里做才发现,业务拆分占了很大一部分工作量。
二、案例:除了出图,还要能按需求找到图
案例对用户决策的重要性不言而喻。新品推荐时,光有产品名字和参数,沟通起来总有点干。机构希望手里有一组可以拿出来解释的视觉材料。
当时把这部分拆成了四种。
- 打板案例:人物、角度、构图相对规整,方便放进产品介绍和海报。
- 日常案例:更接近手机随手拍的生活场景,重点是自然感。
- 周期性案例:围绕同一人物组织多个阶段的画面,考验连续性。
- 局部案例:把注意力放到某个部位,方便说明局部关注点。
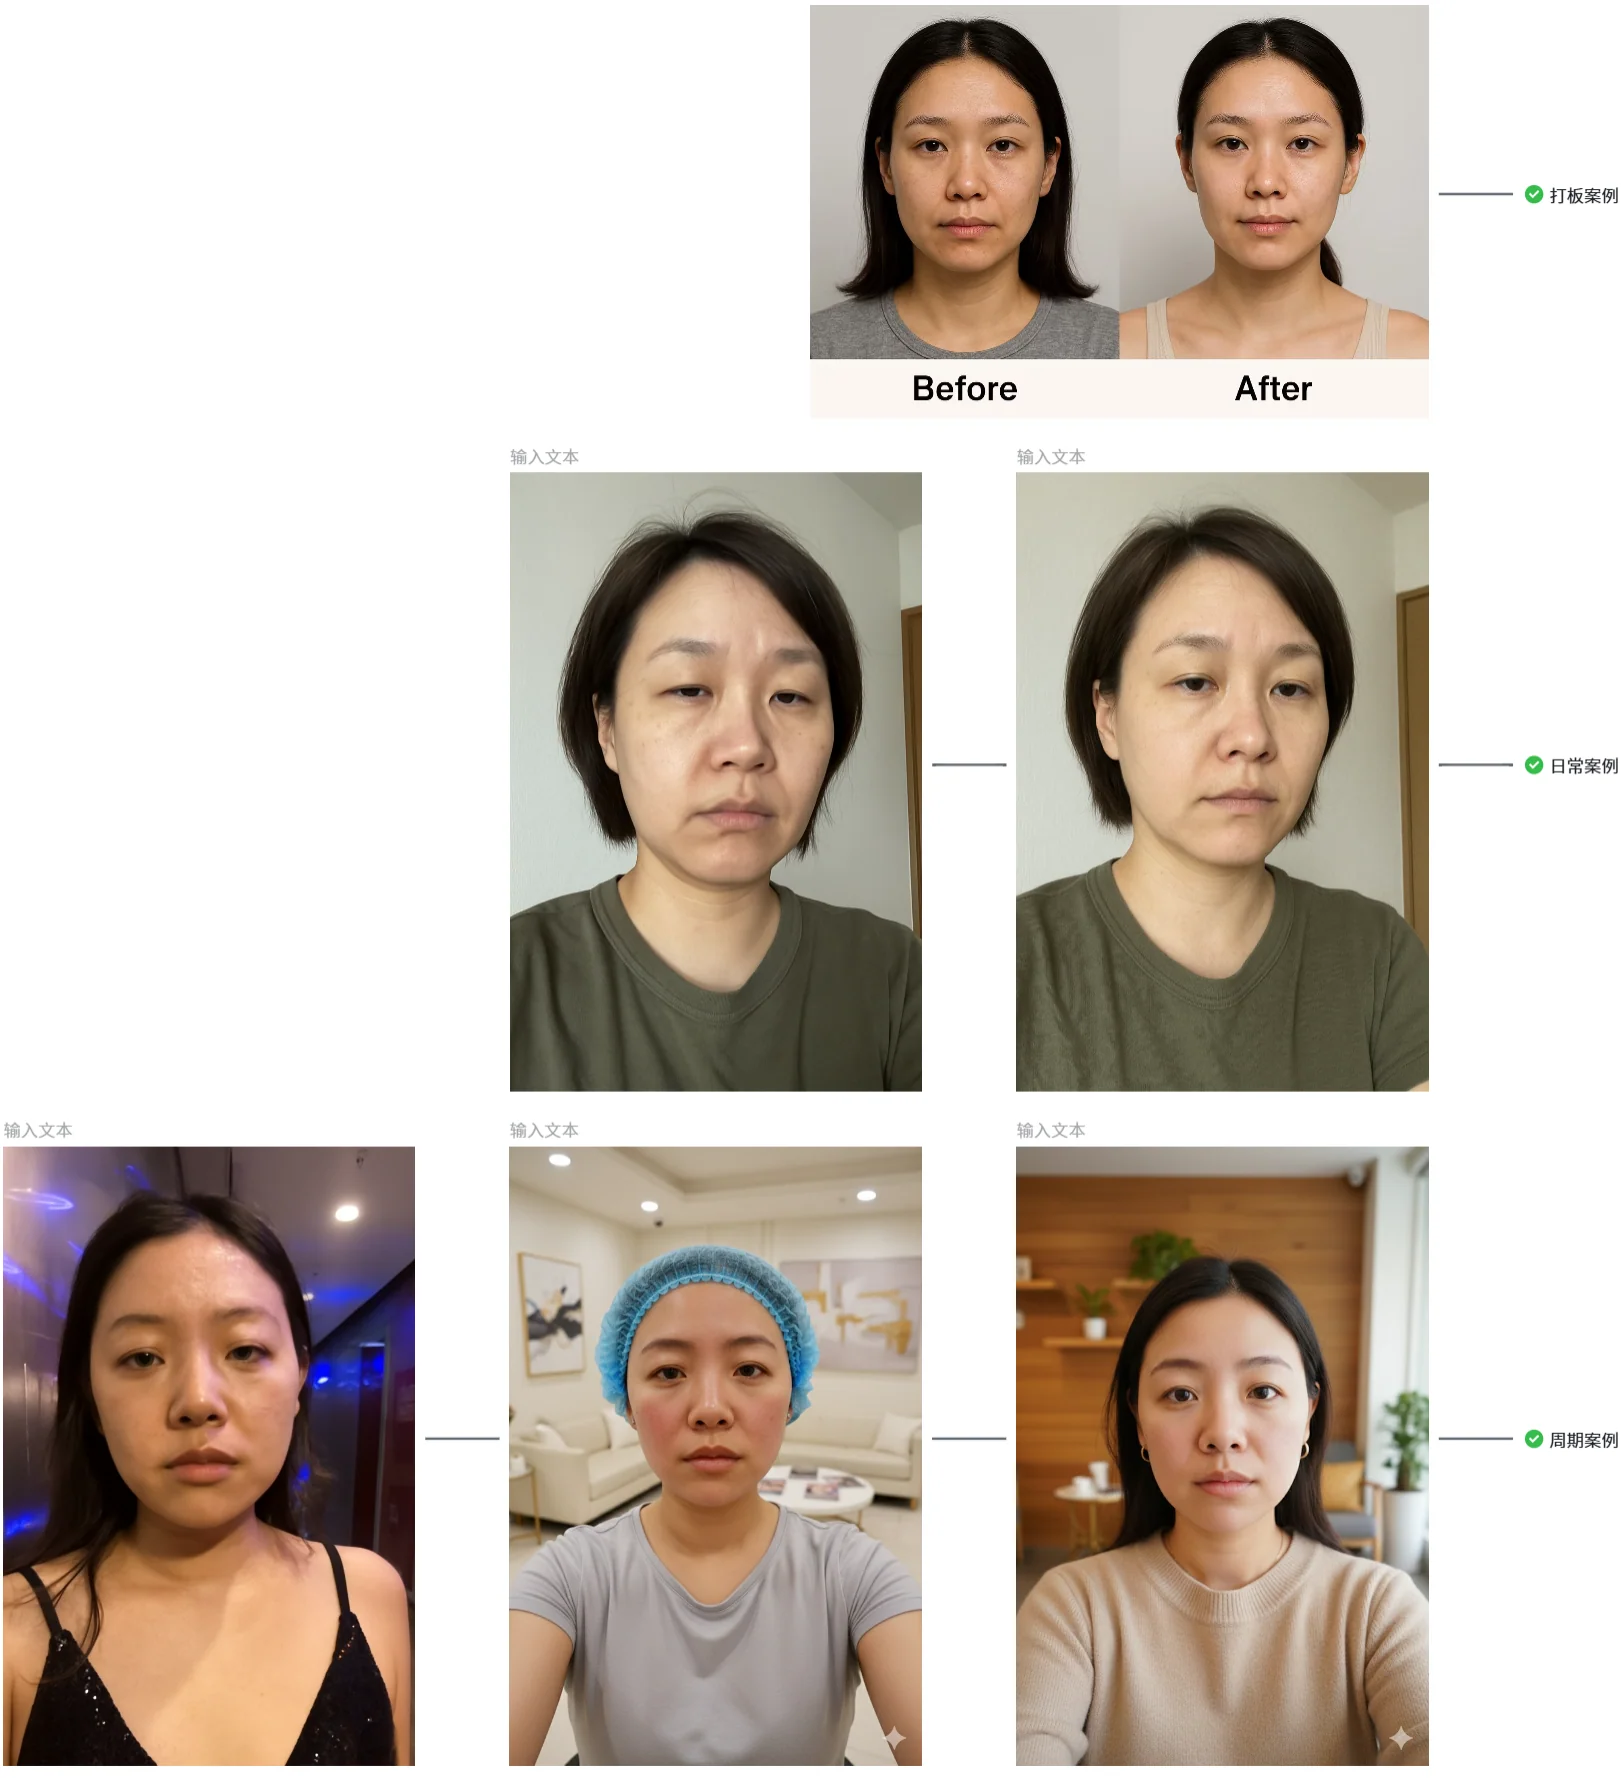
这里主要用的是 gpt-image 和 nano。模型能把人画出来之后,还要继续看:前后是不是同一个人,脸型有没有偷偷换掉,皮肤纹理是否保留,局部变化有没有牵连到其他位置。
尤其是周期性案例。一组图各自都挺好看,放在一起发现像三个人,就没法用了。背景、衣服可以根据场景变化,人物身份得稳住。
顺手把“患者库”也做了
我们还批量跑过一批指定症状的患者形象库。这里的“患者库”,指的是 AI 生成的人物素材库。
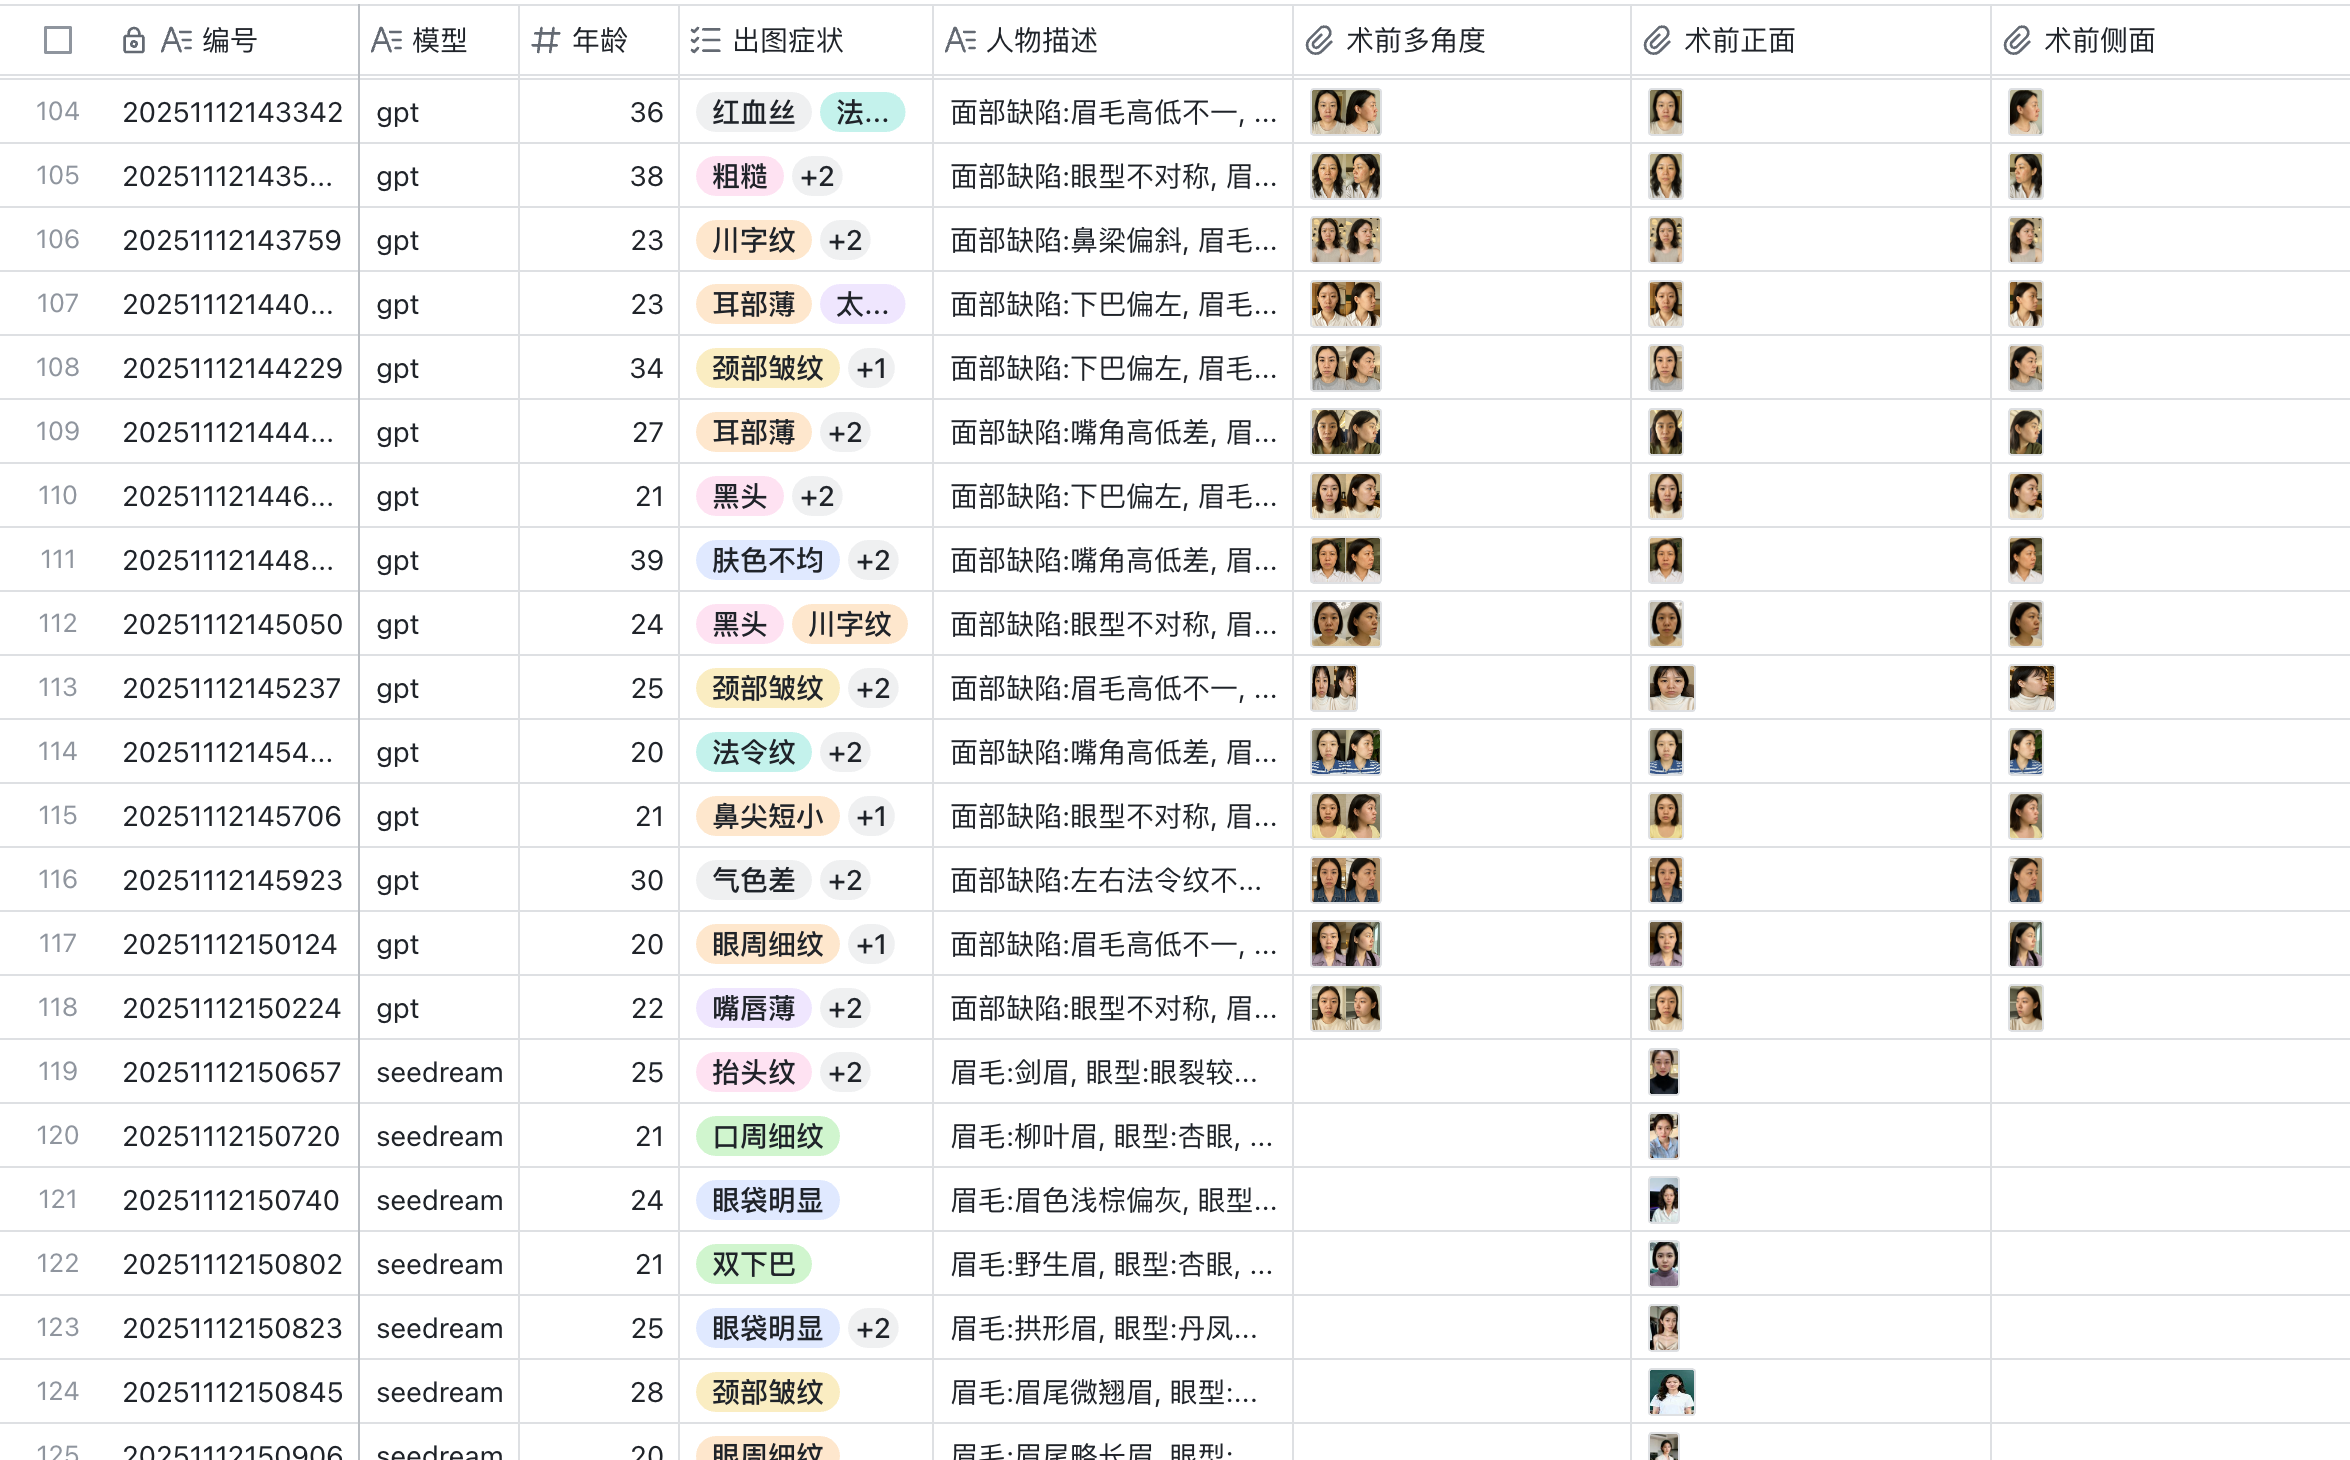
截图里能看到,素材按编号、模型、年龄、症状标签和人物描述组织,同时存正面、侧面、多角度图。
做成这样的好处很实际。后面要围绕某一类关注点做素材,可以先从库里找合适的人物,再继续生成对应内容。人物和图都有了记录,追溯和复用也方便一些。
对我来说,这一步挺像之前做知识库的感受:前面把数据结构想清楚,后面很多零碎需求才接得住。只把图片扔进文件夹,数量一多,找图就成了另一份工作。
查看代码:案例人物与图片生成
import http.client
import json
import base64
import os
import time
import random
import pandas as pd
from datetime import datetime

# # ========================================== 生成图片 ==========================================
# # 1.初始化变量
# ## 部位
part = "面部"
# ## 功效
effect = "祛痘祛痘印"
# ##时间戳
timestamp = random.randint(10000, 99999).__str__()+'_'+time.strftime("%S%M%H%Y%m%d", time.localtime())
# ## 随机数
random_number = random.randint(28, 45)

# 2.生成案例 人物描述 + 效果描述 (部位、功效、产品)
create_person_prompt = f"""
{timestamp}

## 任务要求
- 我需要1个针对中国女性的,{part}部位的描述的说明,以及针对当前女性使用某一款医美产品后的体验说明,以女性第一人称角度描述;
- 这个女性使用了医美产品,治疗了部位{part}、产生了功效{effect}
- 眼部描述要求:一定要具有随机性和差异性,使用不同的种子,{random_number}岁,用于生成完全不一样的{part}部位照片,{part}部位要明显
- 体验说明要求:以女性第一人称角度,描述使用该产品后的体验,例如效果、过程、注意事项等;适当的副作用可以简单提一下,一带而过,但是一定要说到恢复,不要提到硬块硬结;
- 术前针对产品症状的客观描述,以短句的形式,用于后续调用模型生成图片使用,不超过 20个字
- 术后针对产品效果的客观描述,以短句的形式,用于后续调用模型生成图片使用,不超过 25个字
- 根据对应的部位、功效,判断当前效果最好的照片展示部位为正面、侧面
## 返回示例
{{
    "person": "杨阳|34 岁|圆脸|单眼皮细长眼、内眦饱满;鼻梁与鼻根偏低、鼻翼稍宽;厚唇、人中短、下巴圆钝;皮肤自然偏黄,法令纹极浅、右脸颊有一颗小痣、毛孔明显;空气刘海+齐肩微卷,松散发丝遮耳;素颜轻抿嘴;",
    "person_age": "34 岁",
    "person_name":"杨阳",
    "person_description": "34的我做完一个月后感觉脸小了一点。最大的感受就是皮贴骨了.脸变得紧致了。不能说有太大的变化.但每次照镜子自己看着舒服一些这就够了.本人要求没那么高.有一点效果就觉得没白做.照片是苹果原相机后置.无任何美颜。现在摸着下额缘的地方还是有点疼.不能用太大劲儿去洗脸.细纹这些还是有.毕竟只做了一次.多少有一点点改变就可以了.不能要求太多.总体来说这次还是比较成功的."
    "symptom_description":"面部轻度松弛,下颌缘模糊,法令纹较明显",
    "effect_description": "面部轻微上提,下颌缘轮廓稍清晰,法令纹略浅,木偶纹变浅",
    "show_way": "正面"
}}
## 返回结构
- 以json格式返回;
- 只输出 json 回答内容;
{{
    "person": "",
    "person_age": "",
    "person_name":"",
    "person_description": "",
    "symptom_description": "",
    "effect_description": "",
    "person": "",
    "show_way": "",
}}
"""
headers = {
   'Authorization': '',
   'Content-Type': 'application/json'
}
create_person_payload = json.dumps({
   "model": "kimi-k2-turbo-preview",
   "messages": [
      {
         "role": "user",
         "content": create_person_prompt
      }
   ],
   "max_tokens": 4000,
   "temperature": 0.9
})
conn = http.client.HTTPSConnection("api.moonshot.cn")
conn.request("POST", "/v1/chat/completions", create_person_payload, headers)
res = conn.getresponse()
data = res.read()
# print(data.decode("utf-8"))
# exit()
# 返回结果打印 {"id":"019864e97f5f8fbb6f82aec73d351d13","choices":[{"finish_reason":"stop","index":0,"logprobs":null,"message":{"content":"{\n    \"person\": \"28 岁|长脸|右眼略大于左眼、轻微高低眉;山根低、鼻尖略翘;薄唇、人中偏长、下巴宽大且微前突;肤色冷白、两颊红血丝明显、法令纹深、木偶纹清晰;中分直发及锁骨、发尾毛躁;淡妆、嘴角自然下垂;\",\n    \"person_description\": \"做完超声炮整整三周,最大的惊喜是木偶纹真的淡了不少,自拍不用再把嘴角P上去了。过程比我想象疼,尤其下颌缘像被橡皮筋弹,做完当天肿得像仓鼠,冰敷了两天才消。现在洗脸还是避开颧骨,轻揉就行。脸整体往上提了一点,闺蜜说侧面线条利落些,但法令纹只是变浅,没完全消失。医生说一次只能改善5%,我想年底再做第二次。\",\n    \"symptom_description\": \"面部中度松弛,下颌缘松垮,法令纹与木偶纹明显,苹果肌轻微下移\",\n    \"effect_description\": \"提升比例 5%,面部整体轻微上提,下颌缘线条略收紧,法令纹与木偶纹稍变浅\"\n}","refusal":null,"role":"assistant","annotations":null,"audio":null,"function_call":null,"tool_calls":null}}],"created":1754039681,"model":"moonshotai/Kimi-K2-Instruct","object":"chat.completion","service_tier":null,"system_fingerprint":"","usage":{"completion_tokens":244,"prompt_tokens":483,"total_tokens":727,"completion_tokens_details":null,"prompt_tokens_details":null}}
person = json.loads(json.loads(data.decode("utf-8"))["choices"][0]["message"]["content"])["person"]
person_age = json.loads(json.loads(data.decode("utf-8"))["choices"][0]["message"]["content"])["person_age"]
person_name = json.loads(json.loads(data.decode("utf-8"))["choices"][0]["message"]["content"])["person_name"]
person_description = json.loads(json.loads(data.decode("utf-8"))["choices"][0]["message"]["content"])["person_description"]
symptom_description = json.loads(json.loads(data.decode("utf-8"))["choices"][0]["message"]["content"])["symptom_description"]
effect_description = json.loads(json.loads(data.decode("utf-8"))["choices"][0]["message"]["content"])["effect_description"]
show_way = json.loads(json.loads(data.decode("utf-8"))["choices"][0]["message"]["content"])["show_way"]
print("人物描述:",person)
print("人物年龄:",person_age)
print("人物姓名:",person_name)
print("体验说明:",person_description)
print("症状描述:",symptom_description)
print("效果描述:",effect_description)
print("展示方式:",show_way)
# exit()

# 3.组装最终创建案例的提示词
create_case_prompt = f"""
{timestamp}
# 人物描述
<{person}>,一定要严格遵循人物面部特性,避开常见面部种子,
identical face structure and features, same pose, different clothing and jewelry, different hairstyles, maintain consistency in the neck,

# 整体要求
生成做完医美项目的中国女性用户,{show_way}治疗前后对比图,在一张图内左右分布,极其普通的中国女性自拍 iPhone,增加一些瑕疵保证真实性,不要露出手机,对比效果真实自然,不夸张.图片上不生成任何文字.
side-by-side comparison, before ← | → after,

# 图像质量
straight-on portrait, solid light grey background, high resolution 4k, ultra-detailed skin texture, film-like grain, pbr realistic,
# 皮肤细节
makeup-free::1.5, authentic bare-faced skin, visible pores, no exaggerated glow, no airbrush effect, no heavy makeup, no skin smoothing::1.5,
# 对比要求
LEFT side (Before): <{symptom_description}>, subtle clinical lighting,

RIGHT side (After): same people,<{effect_description}>, identical lighting,no changes in neck or eyes, no changes in skin structure,
"""

print(create_case_prompt)

## 生成图像
payload = json.dumps({
   "prompt": create_case_prompt,
   "n": 1,
   "size": "1536x1024",
   "model": "gpt-image-1",
   "quality": "high",  # Options: "high", "medium", "low".Default: "auto".
   "response_format": "b64_json"  # Options: "url", "b64_json".Default: "url". gpt-image-1只支持 base64,url 为第三方自行保存,建议我方存储,后续修改为 b64_json
})
headers = {
   'Authorization': '',
   'Content-Type': 'application/json'
}
conn = http.client.HTTPSConnection("api.zoopcool.com")
conn.request("POST", "/v1/images/generations", payload, headers)
res = conn.getresponse()
data = res.read()
# url 返回结构
# data = {"data":[{"url":"https://midjourney-plus.oss-us-west-1.aliyuncs.com/sora/8d4ab759-eab6-46db-9e2a-b05dc56e6666.png"}],"created":1754376288}
# data = {"data":[{"url":"https://midjourney-plus.oss-us-west-1.aliyuncs.com/sora/6310dfc8-6e38-4062-aaa6-1cf6e1361d98.png"},{"url":"https://midjourney-plus.oss-us-west-1.aliyuncs.com/sora/7bf82556-1a31-481a-a664-a06d60de828b.png"}],"created":1754379298}
## 下载图片到脚本同级目录,并修改名称为{timestamp}_{part}_{effect}.png
try:
    import urllib.request

    # 确保目录存在
    os.makedirs("create_txt/business_case", exist_ok=True)

    # 先解码bytes为字符串,再解析为JSON
    try:
        response_text = data.decode("utf-8")
        response_data = json.loads(response_text)
        print(f"API返回数据: {response_data}")
    except json.JSONDecodeError as e:
        print(f"JSON解析错误: {e}")
        raise
    except UnicodeDecodeError as e:
        print(f"字符串解码错误: {e}")
        raise

    # 检查返回格式并相应处理
    if 'data' in response_data and len(response_data['data']) > 0:

        for index, image_data in enumerate(response_data['data'], 1):
            # 处理URL格式返回
            if 'url' in image_data:
                image_url = image_data['url']
                # 为多张图片添加序号后缀
                if len(response_data['data']) > 1:
                     # 只取第一张,第二张 break
                     if index == 1:
                        filename = f"create_txt/business_case/{timestamp}_{part}_{effect}.png"
                     elif index > 1:
                        break
                else:
                    filename = f"create_txt/business_case/{timestamp}_{part}_{effect}.png"

                try:
                    urllib.request.urlretrieve(image_url, filename)
                    print(f"✅ 图片 {index} 已保存到: {filename}")
                except Exception as download_error:
                    print(f"❌ 下载第 {index} 张图片失败: {download_error}")

            # 处理base64格式返回
            elif 'b64_json' in image_data:
                base64_string = image_data['b64_json']
                print(f"🔍 Base64数据长度: {len(base64_string)}")
                print(f"🔍 Base64数据前50字符: {base64_string[:50]}")

                # 为多张图片添加序号后缀
                if len(response_data['data']) > 1:
                     # 只取第一张,第二张 break
                     if index == 1:
                        filename = f"create_txt/business_case/{timestamp}_{part}_{effect}.png"
                     elif index > 1:
                        break
                else:
                    filename = f"create_txt/business_case/{timestamp}_{part}_{effect}.png"

                try:
                    # 清理base64字符串(去除可能的换行符和空格)
                    base64_string = base64_string.strip().replace('\n', '').replace('\r', '').replace(' ', '')

                    # 检查base64字符串是否有效
                    if len(base64_string) % 4 != 0:
                        # 补齐padding
                        base64_string += '=' * (4 - len(base64_string) % 4)
                        print(f"🔧 已补齐Base64 padding,新长度: {len(base64_string)}")

                    # 解码base64并保存图片
                    image_binary = base64.b64decode(base64_string)
                    print(f"🔍 解码后图片二进制数据长度: {len(image_binary)}")
                    dir_name = os.path.dirname(filename)
                    os.makedirs(dir_name, exist_ok=True)
                    with open(filename, 'wb') as f:
                        f.write(image_binary)
                    print(f"✅ Base64图片 {index} 已保存到: {filename}")

                except Exception as decode_error:
                    print(f"❌ Base64解码第 {index} 张图片失败: {decode_error}")
                    print(f"🔍 Base64字符串样例: {base64_string[:100]}...")
                    import traceback
                    print(f"🔍 详细错误信息: {traceback.format_exc()}")
            else:
                print(f"❌ 第 {index} 个数据项缺少URL或b64_json字段")

    else:
        print(f"❌ 数据格式错误,无法找到图片数据: {response_data}")

except Exception as e:
    print(f"图片处理错误: {e}")

# base64返回结构
# {
#   "created": 1754032787,
#   "background": "opaque",
#   "data": [
#     {
#       "b64_json": "==" 这里是 base64
#     }
#   ],
#   "output_format": "png",
#   "quality": "high",
#   "size": "1536x1024",
#   "usage": {
#     "input_tokens": 438,
#     "input_tokens_details": {
#       "image_tokens": 0,
#       "text_tokens": 438
#     },
#     "output_tokens": 6208,
#     "total_tokens": 6646
#   }
# }

# ========================================== 记录到Excel ==========================================
def record_to_excel(person_info, filename):
    """
    将人物信息和案例文件名记录到Excel文件中
    """
    excel_file = "create_txt/business_case/案例记录.xlsx"

    # 准备要记录的数据
    record_data = {
        "记录时间": datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
        "时间戳": timestamp,
        "人物姓名": person_info.get("person_name", ""),
        "人物年龄": person_info.get("person_age", ""),
        "人物描述": person_info.get("person", ""),
        "体验说明": person_info.get("person_description", ""),
        "症状描述": person_info.get("symptom_description", ""),
        "效果描述": person_info.get("effect_description", ""),
        "展示方式": person_info.get("show_way", ""),
        "治疗部位": part,
        "治疗功效": effect,
        "案例文件名": filename
    }

    try:
        # 尝试读取现有Excel文件
        if os.path.exists(excel_file):
            existing_df = pd.read_excel(excel_file)
            # 将新记录添加到现有数据
            new_df = pd.concat([existing_df, pd.DataFrame([record_data])], ignore_index=True)
        else:
            # 创建新的DataFrame
            new_df = pd.DataFrame([record_data])

        # 保存到Excel文件
        new_df.to_excel(excel_file, index=False, engine='openpyxl')
        print(f"✅ 记录已保存到Excel文件: {excel_file}")

    except Exception as e:
        print(f"❌ 保存Excel记录失败: {e}")

# 收集人物信息
person_info = {
    "person_name": person_name,
    "person_age": person_age,
    "person": person,
    "person_description": person_description,
    "symptom_description": symptom_description,
    "effect_description": effect_description,
    "show_way": show_way
}

# 生成案例文件名
case_filename = f"{timestamp}_{part}_{effect}.png"

# 记录到Excel
if 'filename' in locals():
    # 如果图片下载成功,使用实际的文件名
    actual_filename = filename.split('/')[-1]  # 只保留文件名部分
    record_to_excel(person_info, actual_filename)
else:
    # 如果图片下载失败,仍然记录预期的文件名
    record_to_excel(person_info, case_filename)
三、产品海报:不同的品,讲法差很多
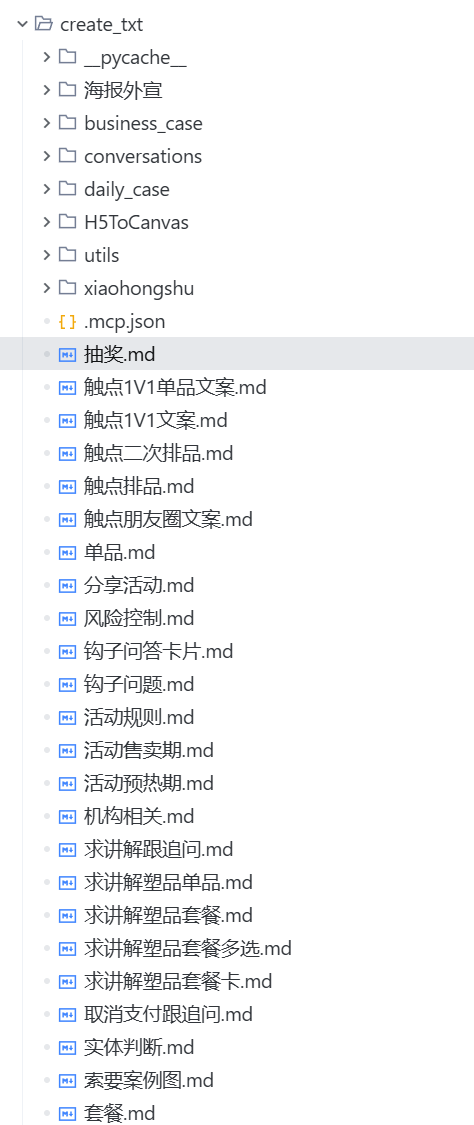
当时的素材与提示词工程目录。
海报大方向分成活动海报、日常朋友圈海报和产品海报。前两种比较容易理解,产品海报继续往下拆,才发现门道不少。
最初也很容易觉得:把产品讲明白,不就行了?
实际做下来,不同商品类型的塑品重点确实不一样。
| 产品海报类型 | 内容重点 |
|---|---|
| 单品 | 原理、参数、特点,以及有依据的效果信息 |
| OEM 品 | 独特之处具体在哪,依据是什么,避免只换个名字 |
| 联合治疗 | 两个项目为什么组合、各自承担什么作用,协同价值有什么依据 |
| 竞品对比 | 适用场景与选择差异,帮助客户理解哪种更适合自己 |
| 常见问答 | 汇总用户最关心的问题,让咨询人员随时有内容可以解释 |
比如单品介绍,用户需要先理解它是什么。OEM 品则更容易被追问:和我听过的那个有什么区别?联合治疗要把大家想表达的“1+1>2”讲具体,也要有资料支撑。竞品对比很考验表达,直接踩别人很容易把内容带偏,围绕客户需求讲选择理由更有用。
这些差别最终都得落到内容顺序上。先讲什么、哪一块放大、哪一块只需要补一句,各种海报不能共用同一套标题然后替换产品名。
技术路线容易讲,细节要慢慢磨
这个产品和 Seede 是同一时期推出的。当时也和它的创始人 LongYi 一起聊过项目技术方案和产品建议。
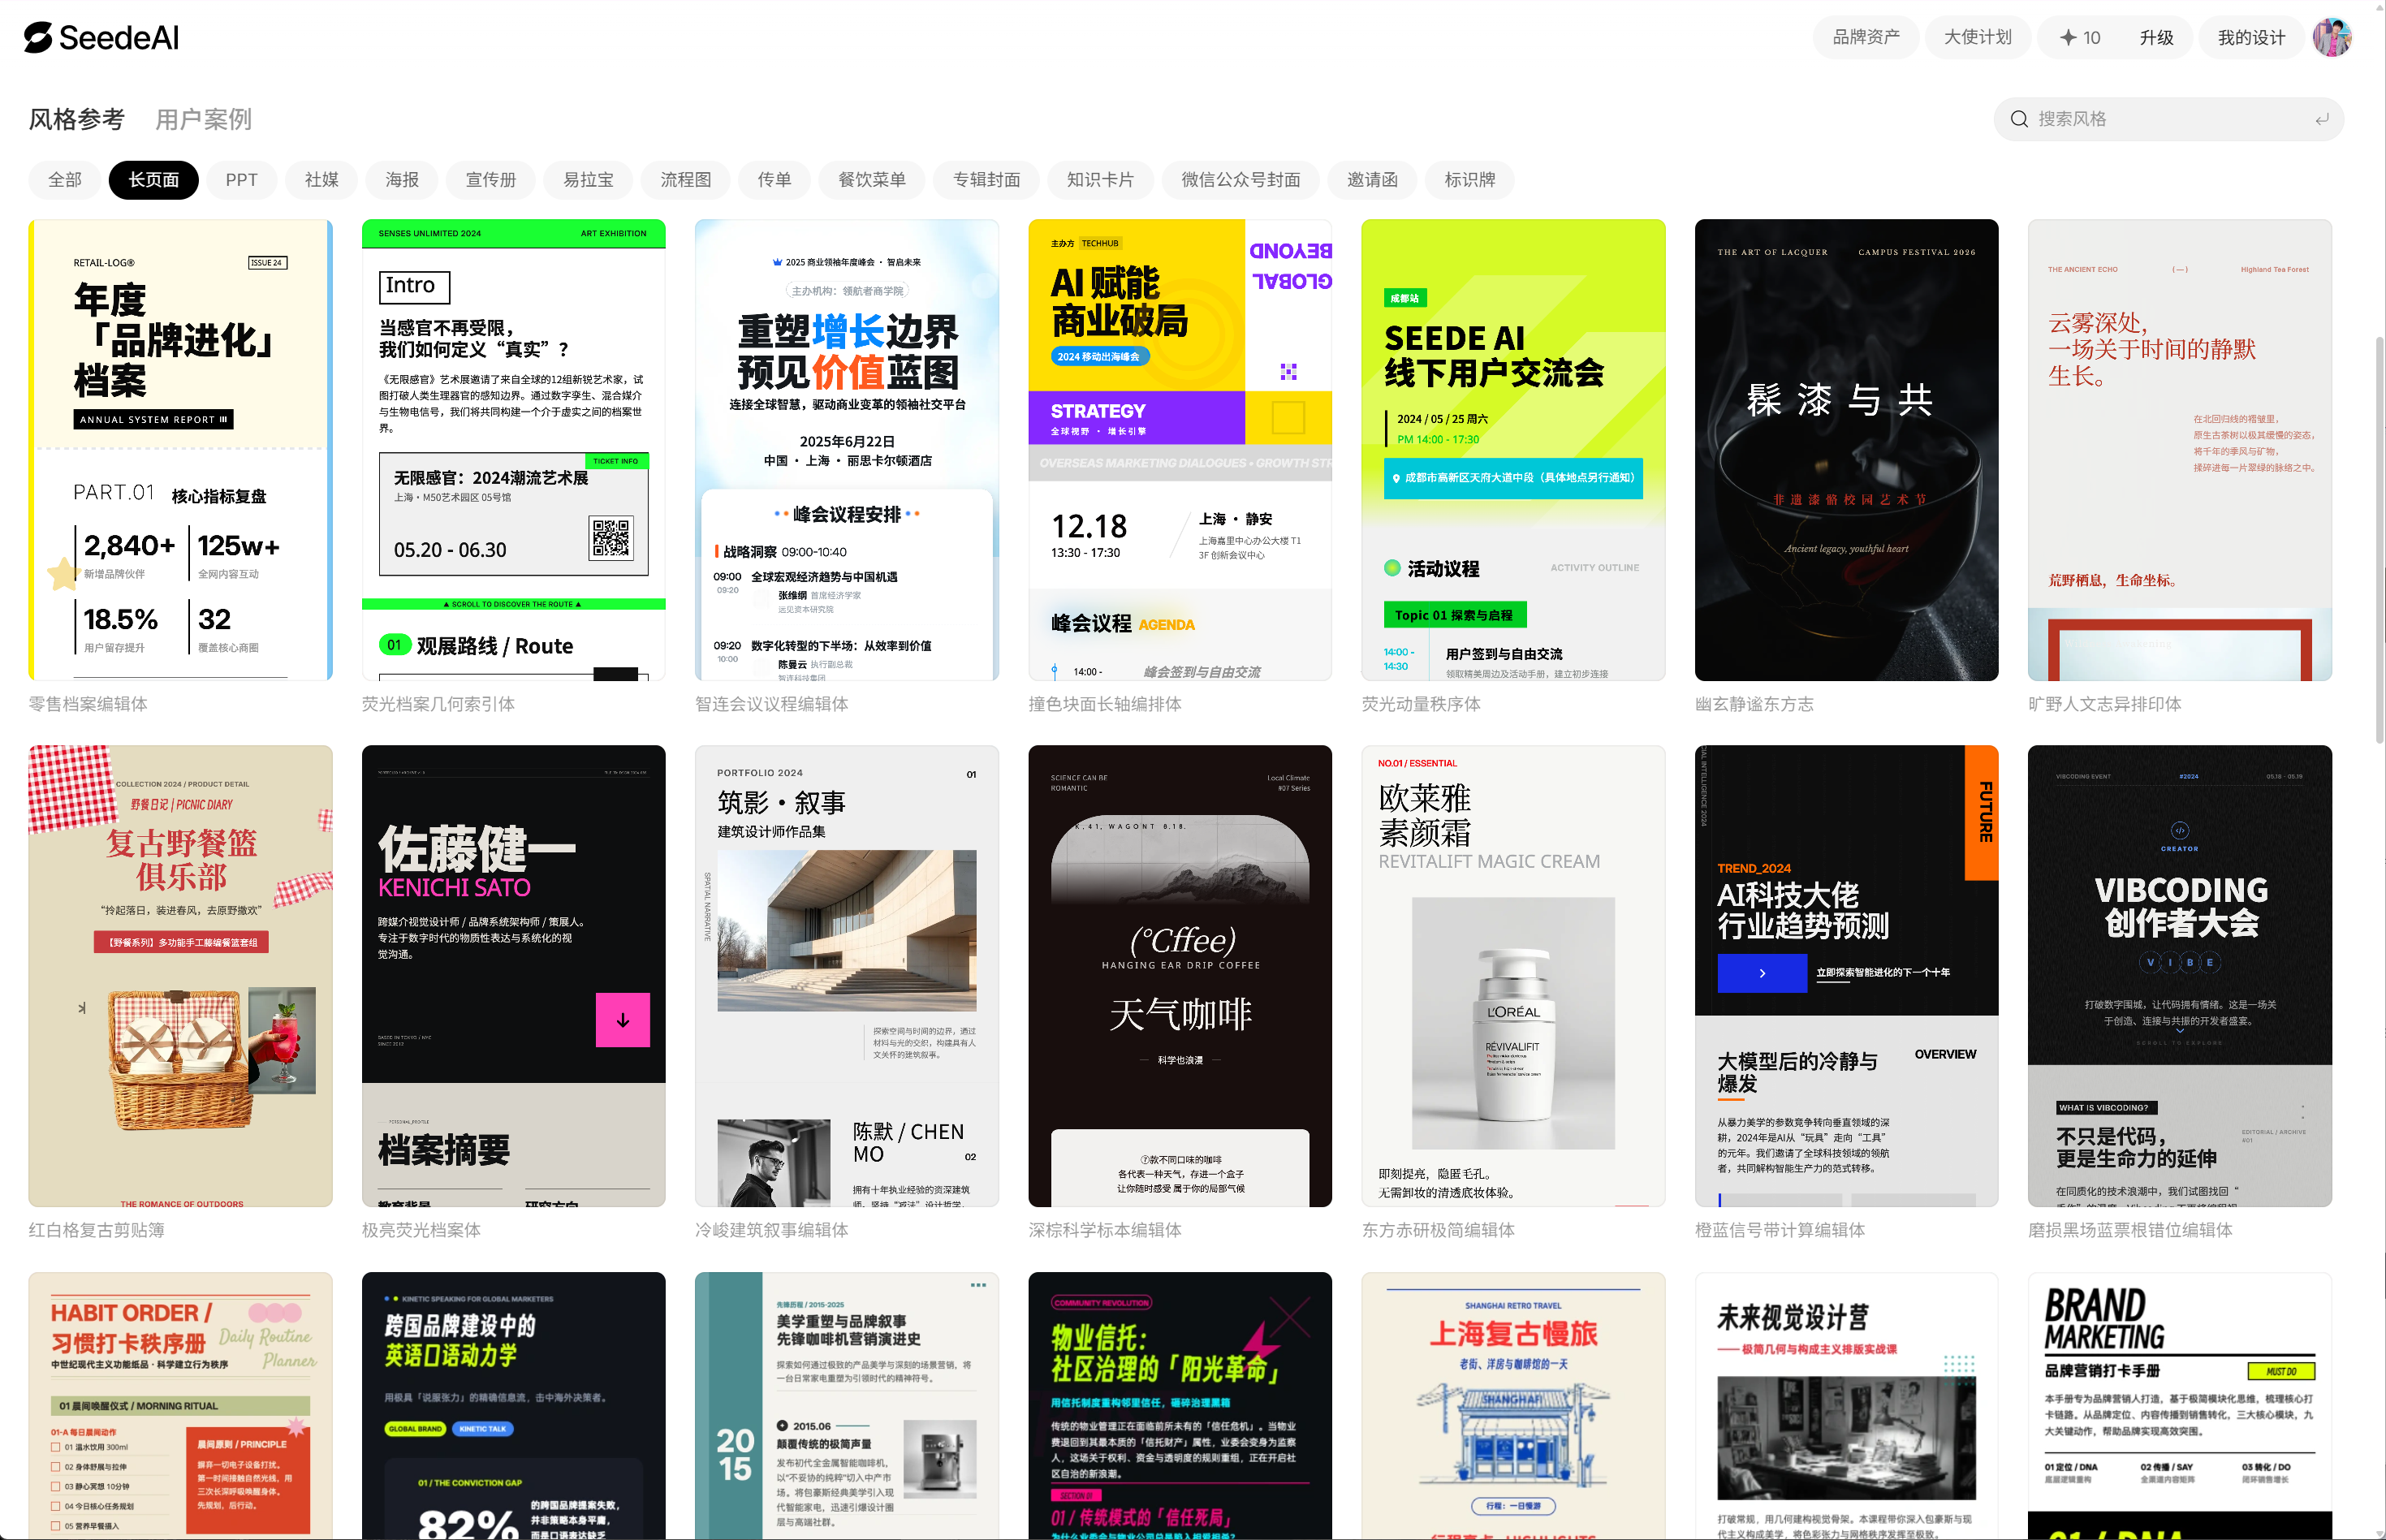
SeedeAI 的风格参考页面。
这类产品的底层实现路线,拆开看其实不复杂:模型先生成 HTML/CSS 页面或者 Canvas 的布局与绘制代码,按模块生成背景图和视觉元素,再处理文字排版,最后做后链路校验和导出。
难的是把这一条链路磨顺。
中文多一个字会不会换行,长产品名能不能放得下,数字和单位有没有分家,背景好看但字看不清怎么办,导出的长图有没有截断……每一项单独看都挺小,放到批量生成里就很要命。
老话题了,还是得“屎上雕花”。😂
当时我的体验是,前端能力越强的模型,做出来的排版通常也越漂亮。那一阶段我更推荐 Gemini 3 和 Claude。
查看代码:联合治疗海报生成
其中联合治疗代码,其他所有的提示词和代码都在temp_code
from openai import OpenAI
import os
import re
import io
import math
import datetime
import json
import time
import random
import html as htmlesc
from pathlib import Path
# 引入数据库连接文件 db_connect.py
# from db_connect import PostgresDB
import sys
try:
    from db_connect import PostgresDB  # 同目录文件
except ModuleNotFoundError:
    # 兼容从仓库根目录运行,加载 create_txt/db_connect.py
    sys.path.append(str(Path(__file__).resolve().parent.parent))
    from db_connect import PostgresDB

client = OpenAI(
  base_url='https://openrouter.ai/api/v1',
  api_key='',
)

# 读取同目录下的 Markdown 文件作为提示词
script_dir = os.path.dirname(os.path.abspath(__file__))
md_path = os.path.join(script_dir, "H5套餐海报.md")
with open(md_path, "r", encoding="utf-8") as f:
  prompt_text = f.read()


db = PostgresDB(env_prefix="CONTENT")
product_id = "1575,75"
title_text = ''
rows = db.execute_query(f"SELECT * FROM content_library_baike WHERE product_id IN ({product_id})")
product_baike_text = []
## 遍历rows添加到product_data
for row in rows:
  title_text = title_text + row['product_name'] + "+"
  product_baike_text.append({
    "id": row['id'],
    "产品名称": row['product_name'],
    "生产厂家": row['manufacturer'],
    "产地": row['origin'],
    "品牌商|代理商": row['brand'],
    "上市时间": row['available_time'],
    "认证情况": row['certification'],
    "认证编号": row['cert_no'],
    "价格区间": row['price_range'],
    "产品成分": row['ingredients'],
    "产品特点": row['features'],
    "市场定位": row['market'],
    "产品功效": row['effects'],
    "使用部位": row['body_parts'],
    "治疗方法": row['method'],
    "技术要点": row['tech_points'],
    "使用人群": row['group'],
    "操作前注意事项": row['before_op'],
    "操作后注意事项": row['after_op'],
  })

# print(product_baike_text)
# exit()

# 更稳方案:不把图片 URL 暴露给模型,后置注入
product_ids = list(map(int, product_id.split(",")))
sql = """
SELECT *
FROM public.content_library_case
WHERE audit_status = 'approved'
  AND relation @> jsonb_build_object('product_ids', to_jsonb(%s::int[]))
  AND jsonb_array_length(relation->'product_ids') = cardinality(%s::int[])
ORDER BY ID DESC
LIMIT 1;
"""
rows = db.execute_query(sql, (product_ids, product_ids))
print(rows)
if len(rows) > 0:
  # 如果source != ai 则取 url 字段
  if rows[0]['source'] != 'ai':
    case_images = [rows[0]['url']]
  else:
    case_images = [rows[0]['compare_img_url']]
else:
  case_images = []
# exit()
# 将product_info dict 转为 JSON 字符串填充到模板
# 将产品百科 dict 转为 JSON 字符串填充到模板
# product_baike_text = json.dumps(product_data, ensure_ascii=False, indent=2)
product_baike_text = json.dumps(product_baike_text, ensure_ascii=False, indent=2)
prompt_text = prompt_text.replace("{product_baike}", product_baike_text) # 产品百科
# prompt_text = prompt_text.replace("{product_info}", product_info_text) # 商品信息

## 随机加载 background.py 中的背景图片
from background import Background_list
background = random.choice(Background_list)
# print(background['背景图'])
temp_background = background['背景图']
background['背景图'] = 'https://picaso-static.oss-cn-beijing.aliyuncs.com/haibao'
print(background,temp_background)
prompt_text = prompt_text.replace("{background}", json.dumps(background, ensure_ascii=False, indent=2)) # 背景图片

print(prompt_text)
# exit()

# 统计请求时长(保持请求体结构不变,仅替换 text 内容)
request_start_time = datetime.datetime.now()
print('正在调用模型...')
completion = client.chat.completions.create(
  extra_body={"temperature": 0.7},
  model="google/gemini-2.5-pro",
  messages=[
    {
      "role": "user",
      "content": [
        {
          "type": "text",
          "text": prompt_text
        }
      ]
    }
  ]
)
request_end_time = datetime.datetime.now()
response_time = (request_end_time - request_start_time).total_seconds()
print(f"响应时长: {response_time:.2f} 秒")

# 将 LLM 输出清洗为纯 HTML 文本
def minimal_html_wrapper(content: str, title: str = "") -> str:
  t = (title or "H5 Poster").strip()
  return (
    "<!doctype html>\n"
    "<html lang=\"zh-CN\">\n"
    "<head>\n"
    "  <meta charset=\"utf-8\">\n"
    "  <meta name=\"viewport\" content=\"width=device-width, initial-scale=1\">\n"
    f"  <title>{t}</title>\n"
    "</head>\n"
    "<body>\n"
    f"{content}\n"
    "</body>\n"
    "</html>\n"
  )

def to_pure_html(text: str, title: str = "") -> str:
  s = (text or "").strip()

  # 1) 优先提取 ```html 代码块
  m = re.search(r"```\s*(?:html|HTML|htm)\s*\n([\s\S]*?)\n```", s)
  if m:
    return m.group(1).strip()

  # 2) 其次提取首个通用 ``` 代码块
  m = re.search(r"```\s*\n([\s\S]*?)\n```", s)
  if m:
    block = m.group(1).strip()
    if re.search(r"<html[\s\S]*</html>", block, re.IGNORECASE):
      return block
    return minimal_html_wrapper(block, title)

  # 3) 直接查找完整 HTML 结构
  for pattern in [
    r"<!DOCTYPE\s+html[\s\S]*?</html>",
    r"<html[\s\S]*?</html>",
  ]:
    m = re.search(pattern, s, re.IGNORECASE)
    if m:
      return m.group(0).strip()

  # 4) 没有明确结构时,作为片段包裹生成完整 HTML
  return minimal_html_wrapper(s, title)

def inject_case_images(html_text, urls):
  if not urls:
    return html_text
  # 生成图片标签
  imgs = []
  for u in urls:
    if not u:
      continue
    esc = htmlesc.escape(u, quote=True)
    imgs.append(f'<img src="{esc}" alt="" style="width:100%;display:block;margin-top: 1rem;margin-bottom: 1rem;" />')
  img_block = "\n".join(imgs)

  # 1) 优先占位符
  placeholder = "<!-- CASE_IMAGES -->"
  if placeholder in html_text:
    return html_text.replace(placeholder, img_block)

  # 2) 次选:插在“产品简要营销总结”标题之后
  m = re.search(r"(<h[1-6][^>]*>[^<]*产品简要营销总结[^<]*</h[1-6]>)", html_text)
  if m:
    idx = m.end(1)
    return html_text[:idx] + "\n" + img_block + html_text[idx:]

  # 3) 再次:紧跟 <body> 后
  m = re.search(r"<body[^>]*>", html_text, re.IGNORECASE)
  if m:
    idx = m.end(0)
    return html_text[:idx] + "\n" + img_block + html_text[idx:]

  # 4) 兜底:追加到末尾
  return html_text + "\n" + img_block

def inject_background_images(html_text, url):
  """
  找到 HTML/CSS 中的特殊背景标记:凡是 url(...) 指向
  https://picaso-static.oss-cn-beijing.aliyuncs.com/haibao 下的链接,
  一律替换为传入的 temp_background(url)。

  - 适配 style 属性与 <style> 块;
  - 同时覆盖 background 与 background-image 两种写法(本质都是 url(...))。
  """
  if not url:
    return html_text

  esc_url = htmlesc.escape(url, quote=True)

  # 通用:替换任意 CSS url('...') 或 url("...") 或 url(...)
  # 兼容:凡是以 haibao 基路径开头的链接都替换为实际背景图
  HAIBAO_BASES = [
    'https://picaso-static.oss-cn-beijing.aliyuncs.com/haibao',
    '/haibao',  # 兼容相对路径写法
  ]

  def repl(m):
    prefix, old, suffix = m.group(1), m.group(2), m.group(3)
    old_stripped = old.strip()
    for base in HAIBAO_BASES:
      if old_stripped.startswith(base):
        return f"{prefix}{esc_url}{suffix}"
    return m.group(0)

  pattern = re.compile(r"(url\(\s*['\"]?)([^)\'\"]+)(['\"]?\s*\))", re.IGNORECASE)
  return pattern.sub(repl, html_text)

# 输出内容(清洗为纯 HTML)
output_text = completion.choices[0].message.content
pure_html = to_pure_html(output_text, title_text)

# 先用 temp_background 替换掉 /haibao 占位背景
final_html = inject_background_images(pure_html, temp_background)

# 再注入案例图
final_html = inject_case_images(final_html, case_images)

# 写入 HTML 文件
title_safe = "".join(c for c in title_text if c not in "\\/:*?\"<>|\n\r\t").strip() or "poster"
html_file = os.path.join(script_dir, f"{title_safe}.html")
with open(html_file, "w", encoding="utf-8") as f:
  f.write(final_html)


"""
工具:将 HTML 渲染为图片
- 依赖:selenium (已在 requirements 中添加)
- 需要:本机安装浏览器(推荐 Chrome)。Selenium 4 会自动管理驱动。
"""
# 引用独立模块,便于在任何地方复用
from html_to_image import render_html_to_image,render_html_to_image_and_upload

def run_render():
  out_path = os.path.splitext(html_file)[0] + ".png"

  print(f"渲染HTML为图片: {html_file} -> {out_path}")
  render_html_to_image(
    html_file,
    out_path,
    css_width=550,
    dpr=2.0,
    wait_sec=0.8,
    max_bitmap=16384,
    one_shot=True,
  )
  print(f"已保存图片: {out_path}")


if __name__ == "__main__":
  run_render()
查看提示词:联合治疗海报
联合治疗提示词
## 角色
- 你是一名具有十多年设计经验的移动端网页设计师,我将给你一个售卖产品,你需要将话题的内容按照要求生成html页面

## 售卖产品
- 套餐商品中涉及的产品百科:
    {product_baike}
- 案例图片:
    不要直接插入图片。请在「产品简要营销总结」模块之后,输出一个占位注释:
    <!-- CASE_IMAGES -->
- 背景图片:
    [{background}]

## 你自身对医美成分的理解
- 只用于补充你自身对产品成分的理解,不输出到海报中
    + 成分中的 HA 指的是 透明质酸(Hyaluronic Acid)
    + 透明质酸:不是所有含有透明质酸成分的都是玻尿酸,只有成分为「交联透明质酸」才是「玻尿酸」,其余均为「水光」,如果为「水光」不能提及玻尿酸
    + 非交联透明质酸 和 微交联透明质酸 禁止提及玻尿酸

## 文字内容要求
- 海报标题:
    + 由产品百科中的产品名称组合而来
    + 如果有多个产品中间使用'+'串联
- 表达话题中医美产品信息提炼出的卖点和技术特性,要深入浅出讲透每一个医美产品相关的仪器药品材料;
    + 1.一句话子标题
    + 2.子产品介绍:先统计包含产品数,所有子产品介绍为2句话总结的小区块,在当前页面整体宽度550px下,所有小区块放在一行,高度根据宽度自适应加高,使用样式 flex-direction: row !important;
        - 产品全称,不输出规格
        - 功效说明
    + 3.功效互补:结合两者的功效互补,达成 1+1>2 的效果(合则天下无敌);功效说明+产品特性共同组成这一段内容;字数不要太多,突出重点
    + 4.产品体验
    + 5.技术原理
    + 6.适用人群(不要提及非适用人群)
- 根据话题生成对应的中文文字内容
    + 挖掘并放大产品信息,以足够丰富的维度来科普话题内容
    + 内容用以触达用户一定要口语化,向用户传达百科的同时,激起用户的购买欲望:
    + 重点文字需要使用「不同颜色」的高亮背景标签扩起来,提升视觉重点
    + 文字当中穿插使用Emoji表情符号
    + 大段的文案,需要适当的换行,保证用户的阅读体验
    + 产品使用全称不要简化


## 设计风格
- 整体风格:
    + 科普风格
    + 网页内容不包括 banner 等头部,以及尾部网站信息等,主要以展示内容为主
    + 页面整体宽度550px
    + 顶部 padding-top:100px

- 字体:
    + 大标题:字体使用SourceHanSansSC-Bold-2,使用高饱和色彩,不要受到font-size: inherit的影响;font-size: 2.4rem;
    + 子标题:字体使用SourceHanSansSC-Medium-2,使用高饱和色彩
    + 小标题:字体使用SourceHanSansSC-Bold-2
    + 正文:字体使用SourceHanSansSC-Normal-2
    + 所有 h1,h2,h3,h4,h5,h6的css 样式属性增加 !important,提升优先级

- 字体颜色
    + 根据「背景图整体颜色」进行调整,使用与背景色有清晰对比的颜色,保证阅读的体验
    + 整体字体颜色一致
    + 大标题和子标题使用高饱和深色
    +「产品简要营销总结」使用 text-shadow 加强视觉

- 排版:松紧之间错落有秩,注意呼吸感和留白
    + 大标题和子标题居中展示,单独一行
    + 小标题和大段正文段落文字放在一个区块展示,块区的背景颜色设计为半透明毛玻璃质感;
    + 整个页面 padding-left: 1rem;padding-right: 1rem;

- 背景
    + background-size: cover;
    + background-attachment:scroll;
    + 背景全部展示不要添加backdrop-filter参数

- 案例图片
    + 案例图片参与整个页面的排版,每张案例图的宽度与页面宽度一致
    + 案例图片放在「产品体验」之上,「功效互补」下方,与两者之间保持一定的距离;

## 技术规范
- 使用HTML5、TailwindCSS 3.0+(通过CDN引入)和必要的JavaScript
- 使用专业图标库如Font Awesome或Material Icons(通过CDN引入)
- 字体使用SourceHanSansSC系列

## 禁止
- 禁止生成购买按钮等带有跳转连接的内容
- 禁止生成不包含在「排版文字内容要求」中的内容
- 禁止生成动态效果
- 禁止输出真实价格


## 输出要求
- 提供完整可运行的单一HTML文件,包含所有必要的CSS和JavaScript
- 确保代码符合W3C标准,无错误警告
- 适合在pad端竖屏阅读和截图传播
四、宣传文案:同一份资料,换成客户听得懂的讲法
文案也需要单独做。
活动预热要交代什么时候开始、有什么内容;朋友圈介绍要让人快速看懂一个重点;客户私聊追问时,又需要更完整的解释。把产品说明书整段复制过去,阅读体验通常不太好。
前面的脑图里,其实已经能看到同一场活动拆成预热期和活动期。预热时让人知道有这件事,正式开始后再把参与方式和具体信息补齐,节奏就不一样。
如果现在重新整理这套产品,我会把文案输入尽量结构化:产品资料、适用场景、目标人群、可引用的依据、价格和活动时间,都先固定,再让模型按照使用场景改写。
这样海报、口播、朋友圈之间才有共同的事实底稿。否则同一个品,海报写一套,口播又多出几个卖点,咨询师最后还要自己去对,省下的时间又还回去了。
至于语气,我会要求模型少一点万能的“姐妹们冲”,多一点具体问题。客户到底在关心什么,把这个问题说清楚,内容就有了起点。所有的提示词都在temp_code开源项目了哈。
五、数字人:家里的 4090 终于派上用场
做这个项目的时候,ComfyUI 正火,家里的 4090 刚好派上用场。
当时调研了不少底模,也在本地跑了一轮。最后在我的测试条件下,InfiniteTalk 的效果最合适,显存也够用,就搓了一套工作流。TTS 则选了当时我觉得表现最好的 IndexTTS2。
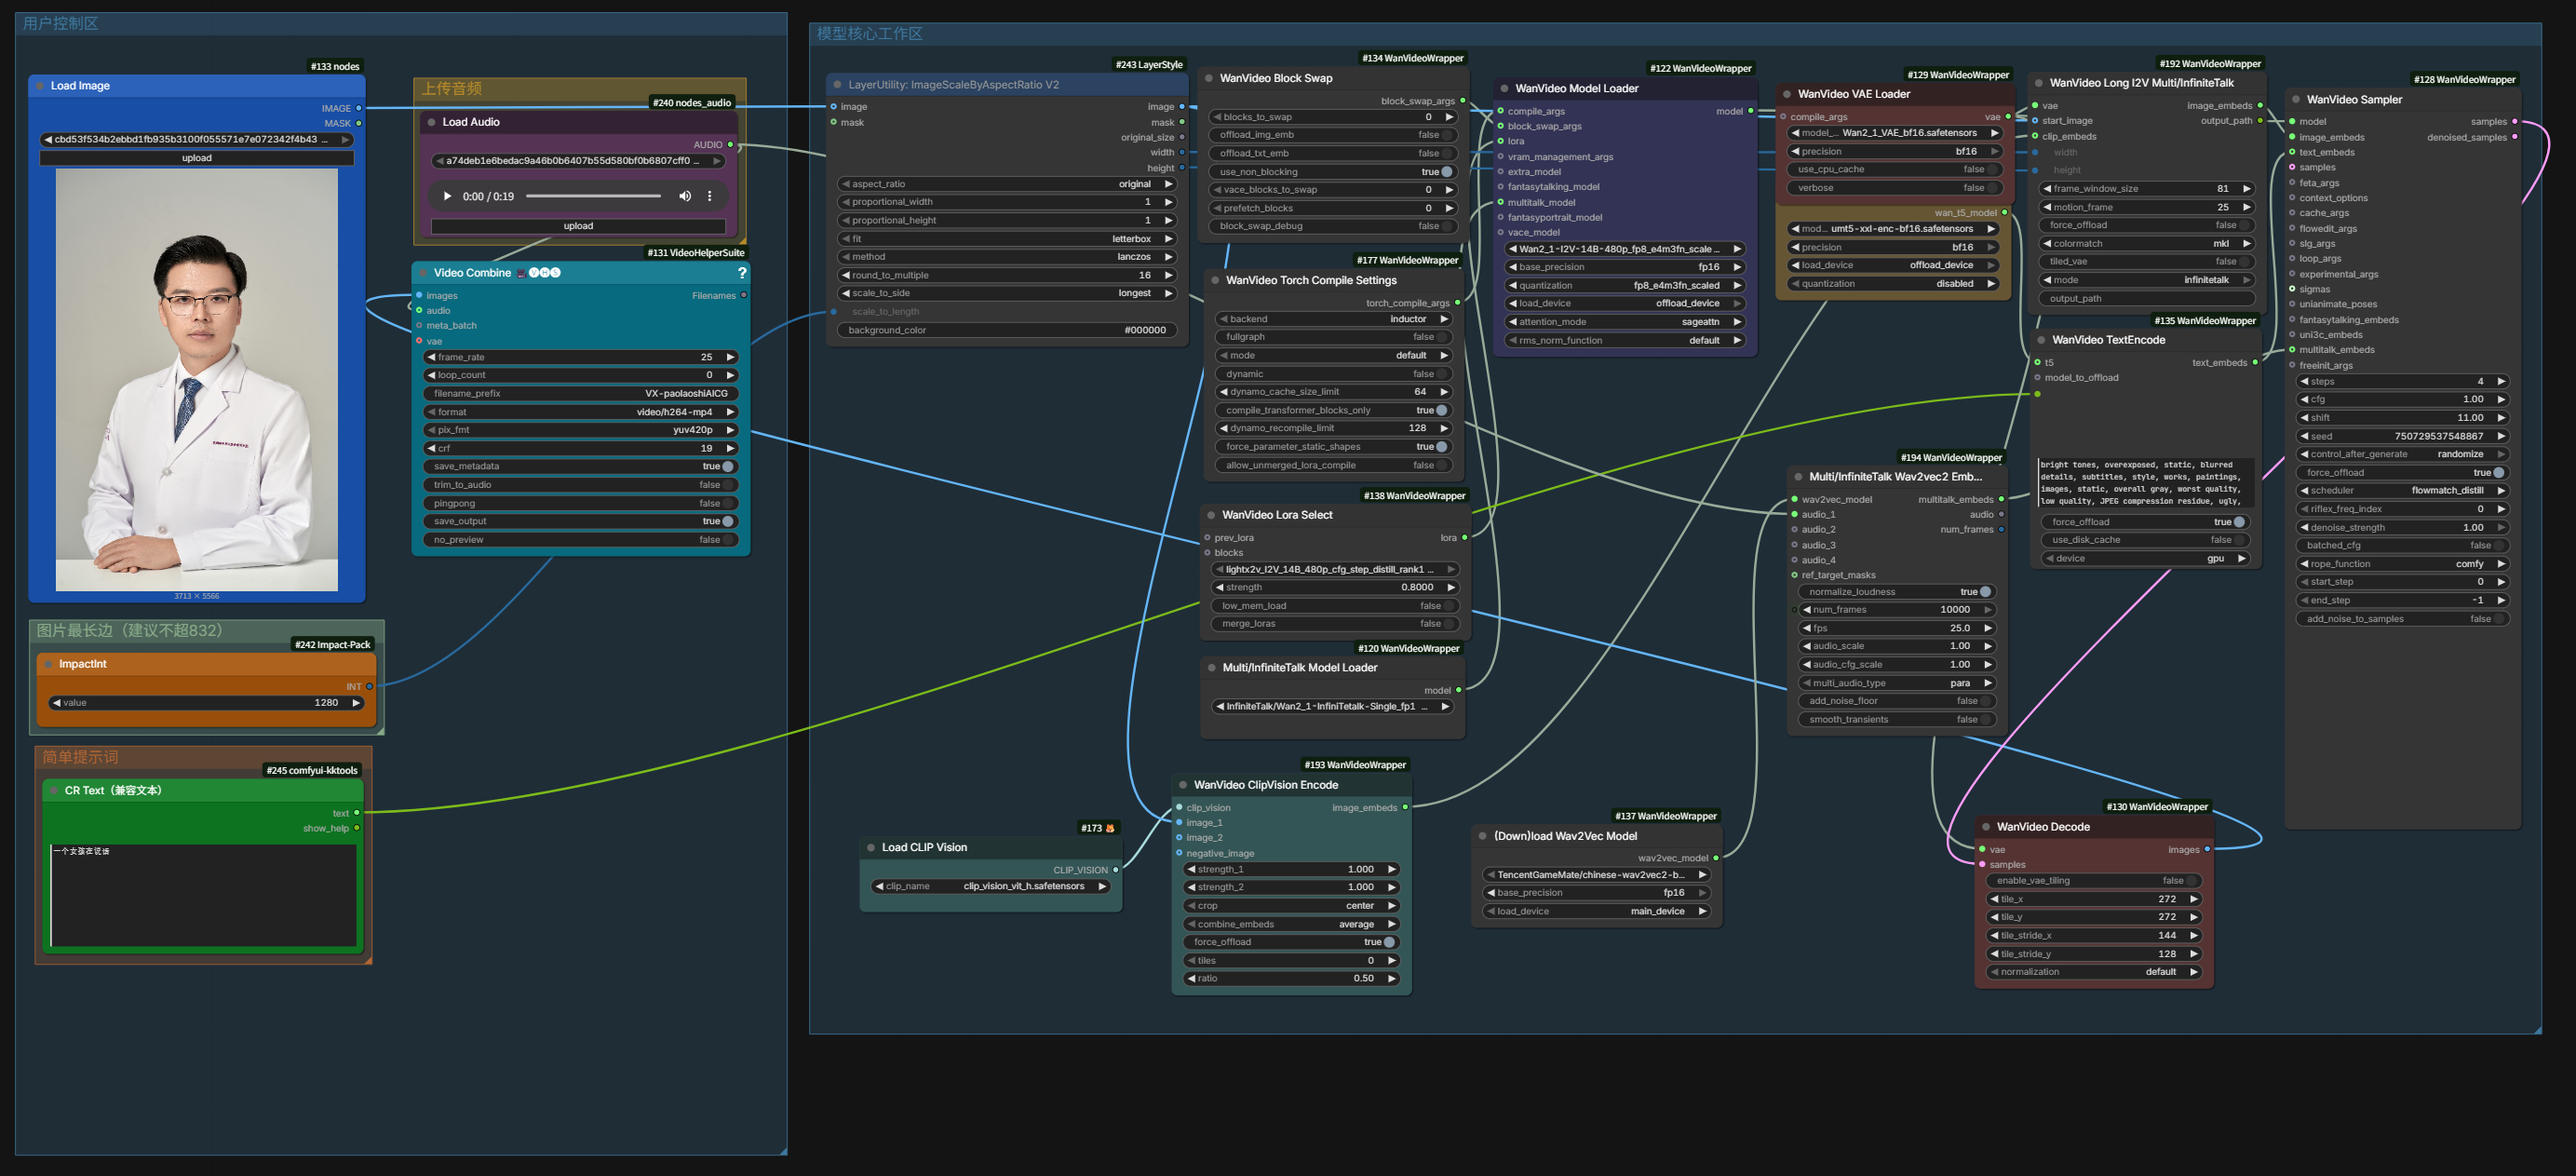
当时在本地跑的 ComfyUI 工作流,点开可以看节点细节。
视频类型支持单人口播、问答和面诊。做下来,单人口播和问答的效果更好。面诊因为涉及双人视角,看上去还是不够真实。
单人画面里,观众主要看脸、口型和动作。换成双人面诊,两个人的视线、回应时机和镜头关系都得对上,对自然感的要求一下就高了。
这是当时的项目流程图。
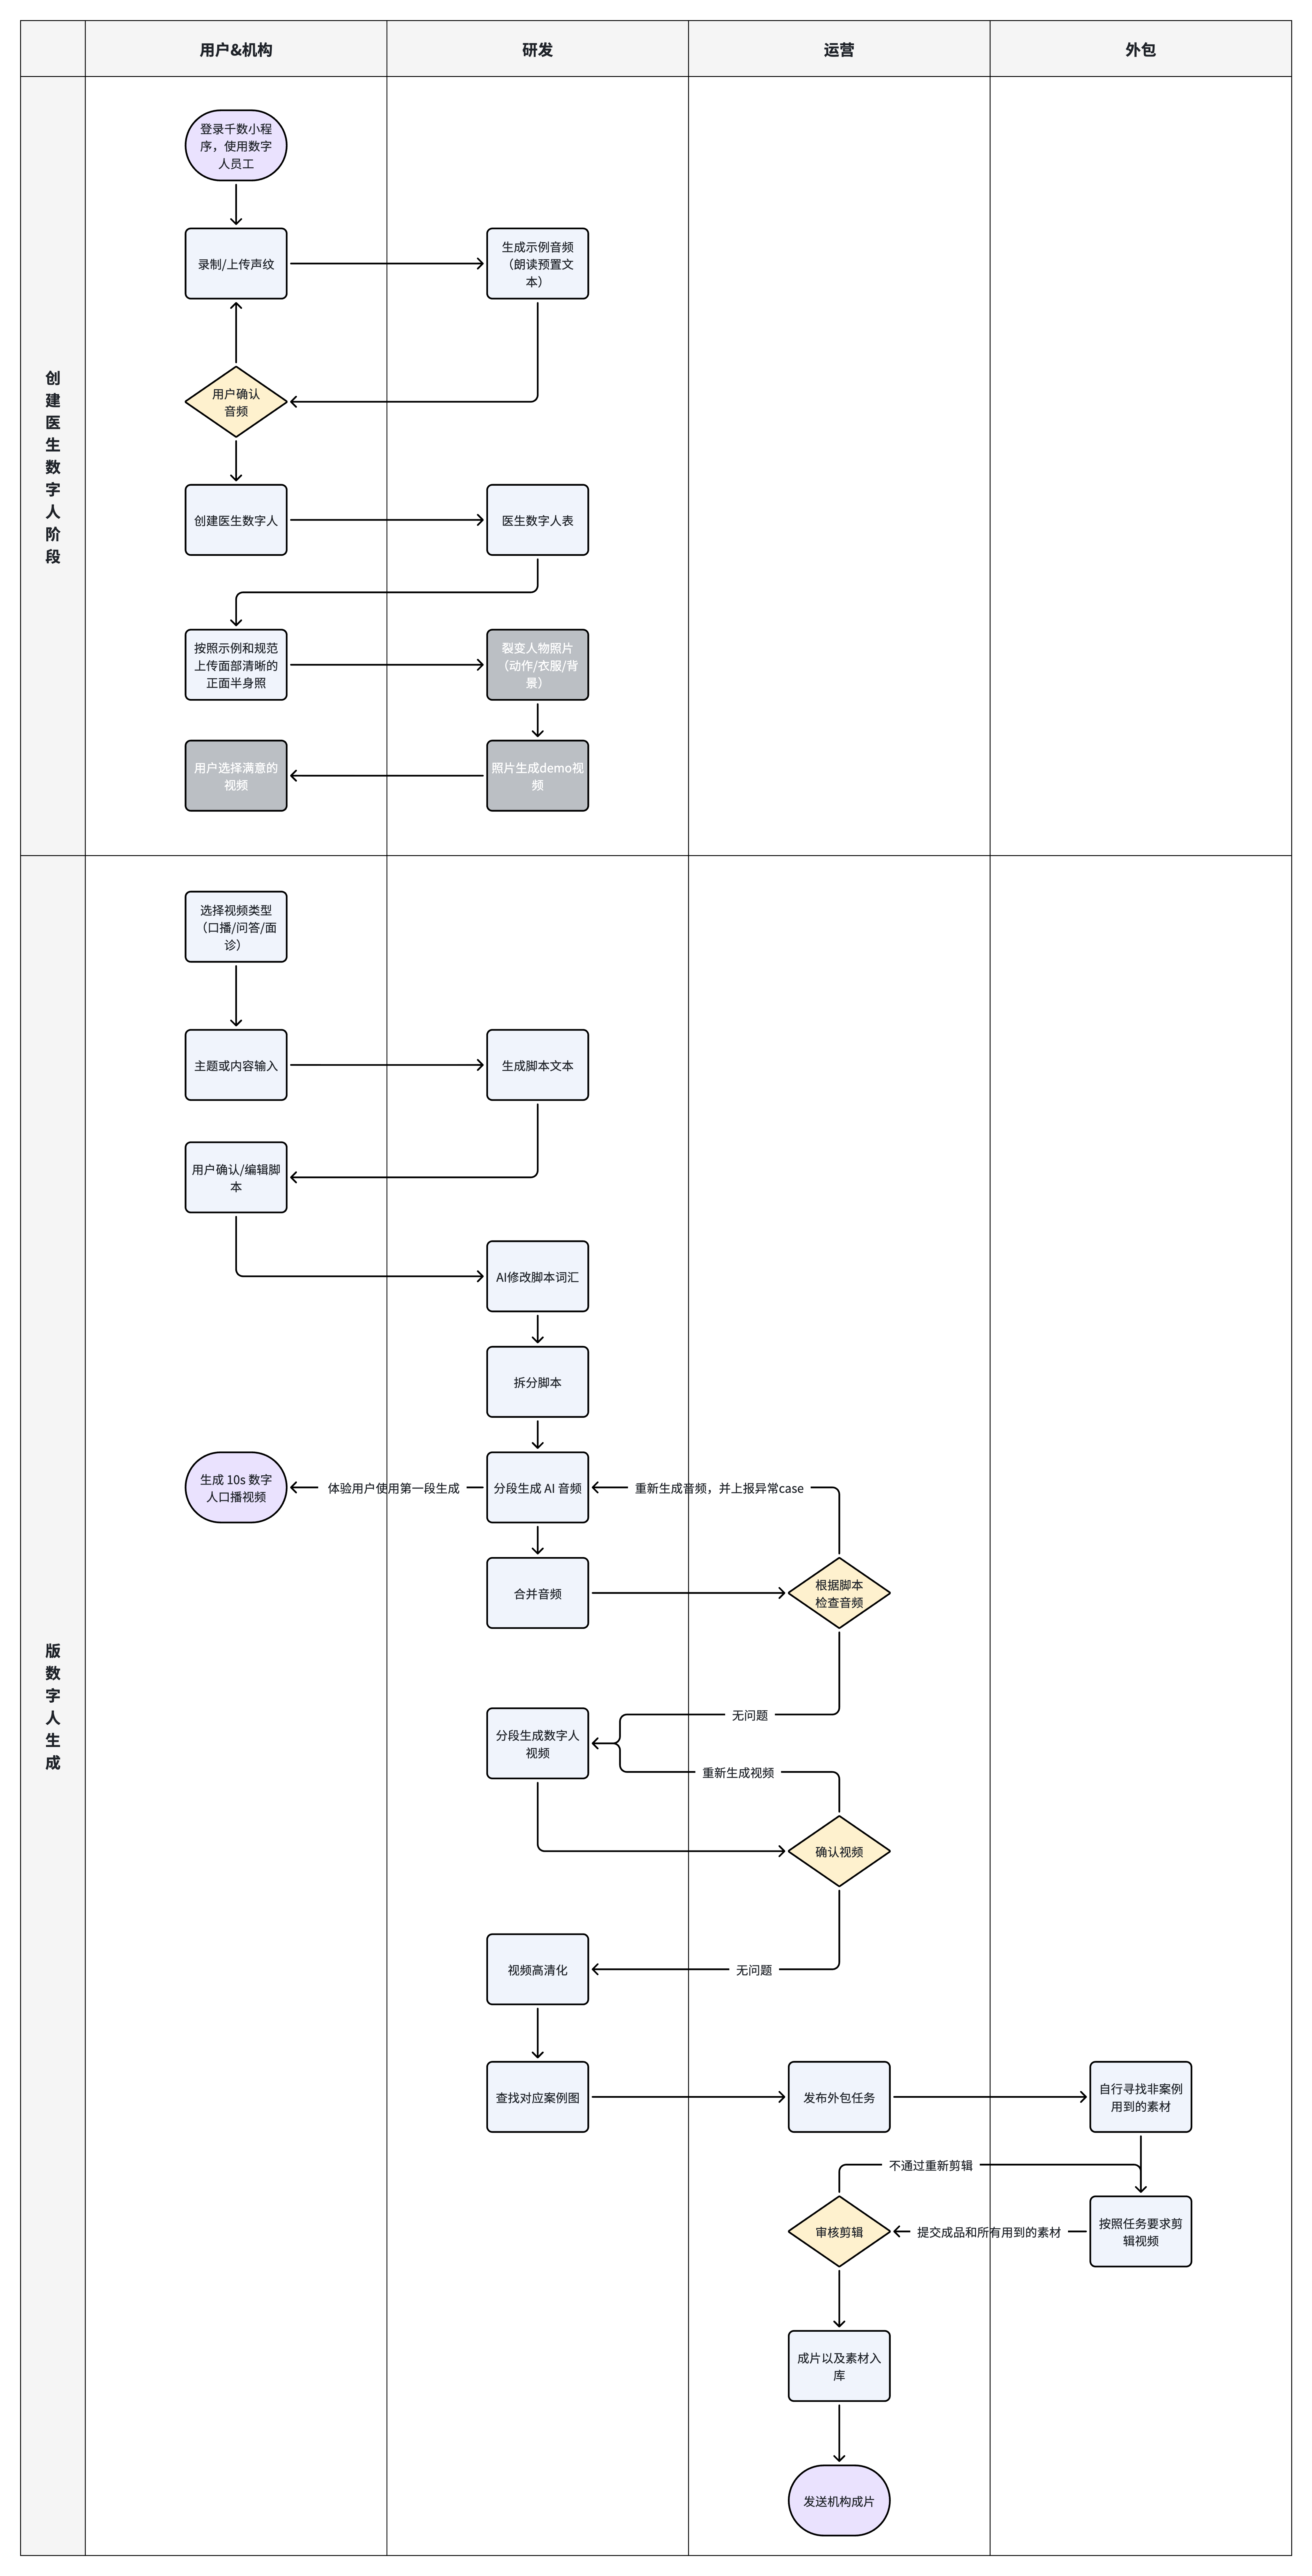
图里其实分成两段:先创建数字人,确认声音和人物形象;后面再围绕具体主题生产内容。
脚本确认后做口语化处理,拆分脚本、分段生成音频,再检查音频;没有问题才继续生成视频。异常片段重新生成,最后再进入高清化、素材匹配和剪辑。
这里保留了不少人工环节。尤其是读错字、音频听着别扭、局部画面不自然这些问题,成片之前得有人过一遍。流程图画出来,也更容易看清研发、运营和外包之间怎么交接。
IndexTTS2 的小经验:先把文字改成可以说的话
有些内容写在文档里很正常,直接丢给 TTS 就容易出问题。
比如:
3-5改成“3到5”或“3至5”。III型改成“三型”。
脚本先做一遍口语化润色,减少不必要的符号,长句适当拆开。这些动作很小,但比盯着一段读错的音频反复生成省心。
这里也有个顺序问题:脚本内容先让人确认,再生成朗读用文本。术语的说法变了,意思和数字还得保持一致。
照片怎么拍,后面更省事
当时测试下来,效果较好的照片大多有两个特点:
- 半身,面向镜头,或者稍微带一点角度,脸部清晰。
- 单手或双手做向别人介绍的手势,和讲解场景比较匹配。
所以数字人这件事,输入照片值得认真准备。前面选对一张照片,后面少救不少画面。
成本和剪辑
最后优化下来,按当时的生成成本口径,不算剪辑,一条口播视频大约 8 元。剪辑当时人工来做,40 元一条。
这两个数分开看更清楚:8 元对应生成环节,成片还需要剪辑和审核,不能直接当成完整交付成本。
最近又看到 ChatCut 这类 AI 剪辑项目,我主观感觉完成度已经接近人工的九成。当然,这里的“九成”是我看效果的感受,没做过严格对照测试。对我更有吸引力的是,可以继续试试把当时依赖人工的剪辑环节接进去。
放一条当时的示例
六、小红书软文:把人物、故事和图片接起来
小红书这一块,用的是生活感比较强的案例图,再配合具体人群和场景写内容。
从产品介绍直接跳到一篇软文,中间其实省略了很多东西:谁在讲,她有什么困扰,为什么会关心这个产品,文章里的配图应该出现在哪个场景。把这些拆出来,生成流程就清楚多了。
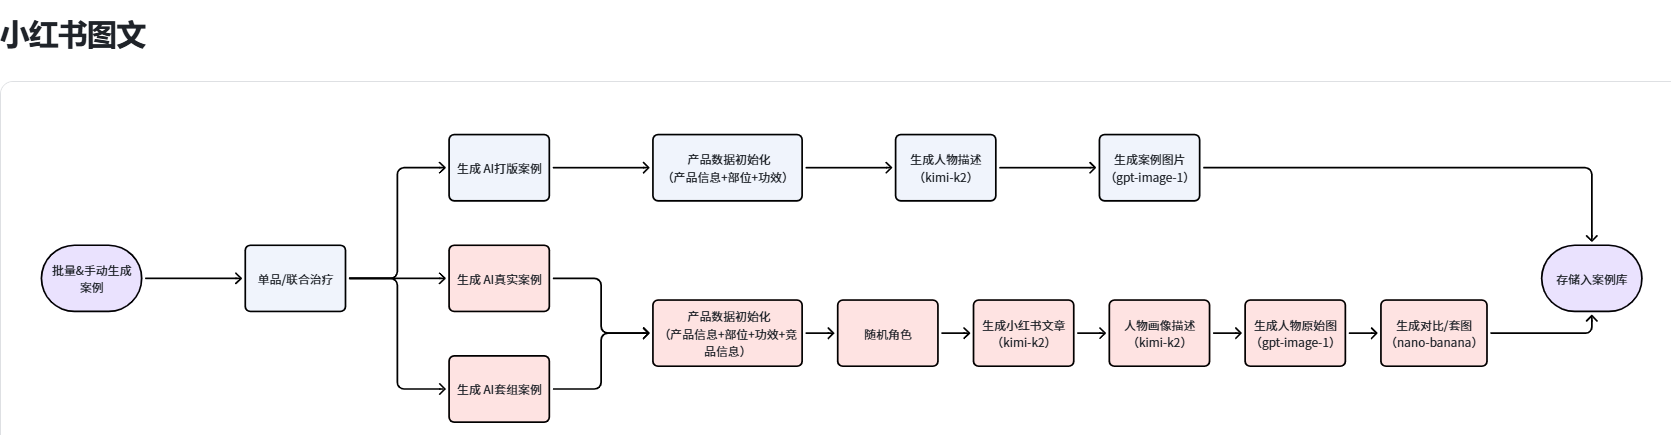
原流程图里,打板图是一条分支:初始化产品信息、部位和功效信息,生成角色描述,再出图。
另一条分支则更长:补充产品和竞品信息,随机角色,生成文章,再根据人物画像生成场景图,最后生成对比套图,存入案例库。当时图中记录的分工是 Kimi K2 负责人物和文章,gpt-image-1 负责人物场景图,nano-banana 负责后续套图。
原图把其中一类命名为“AI真实案例”。这里说的是真实感和生活场景风格,内容仍然是生成样稿。
这一块给我的感受是,图文放在一起看才容易发现问题。文章讲的是出差女性,配图却全是棚拍;文案里描述了不同阶段,图片中的人又对不上,读者一眼就会出戏。
自己发了两篇,拿到一点小反馈
我自己账号当时只发了两篇相关内容,其中一篇阅读量到了 8000 左右,按自己的统计,赞藏评合计大概 30。
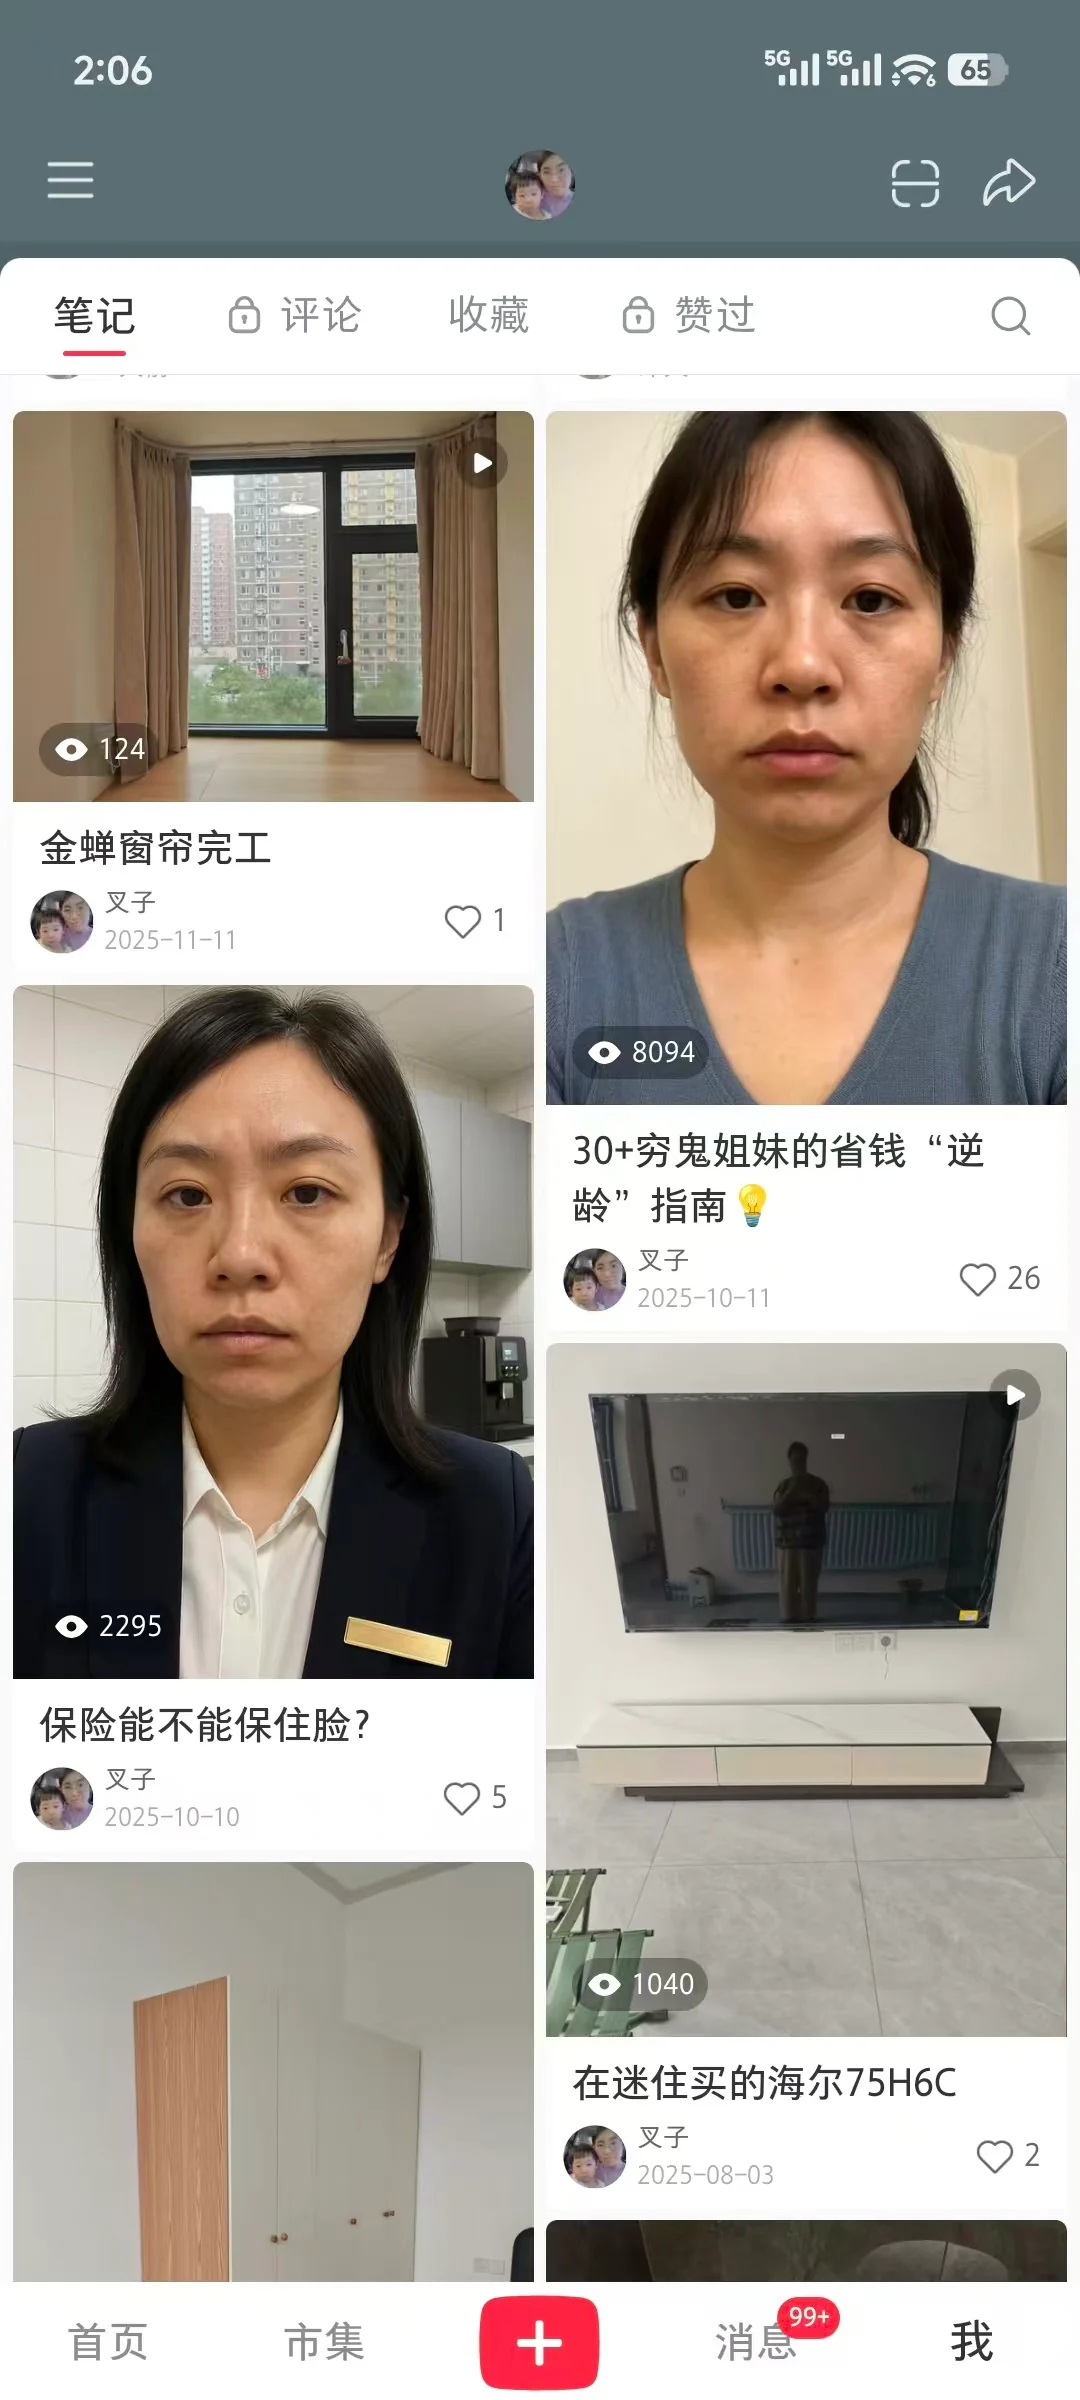
截图里能直接看到,一篇 8094 次浏览、26 个赞,另一篇 2295 次浏览、5 个赞。收藏和评论没有在这张图里展开。
对这么少的样本,我会把它当成值得继续测试的反馈。说明这种生活场景的图文有人愿意点进来看,至于能不能稳定复现、能不能带来咨询和成交,还需要后面的数据。
一份历史生成样稿
这份《30+穷鬼姐妹的省钱“逆龄”指南》比较能看出当时的写法:从出差场景切入,带出外观困扰和预算限制,再用分步骤叙事把产品放进去。
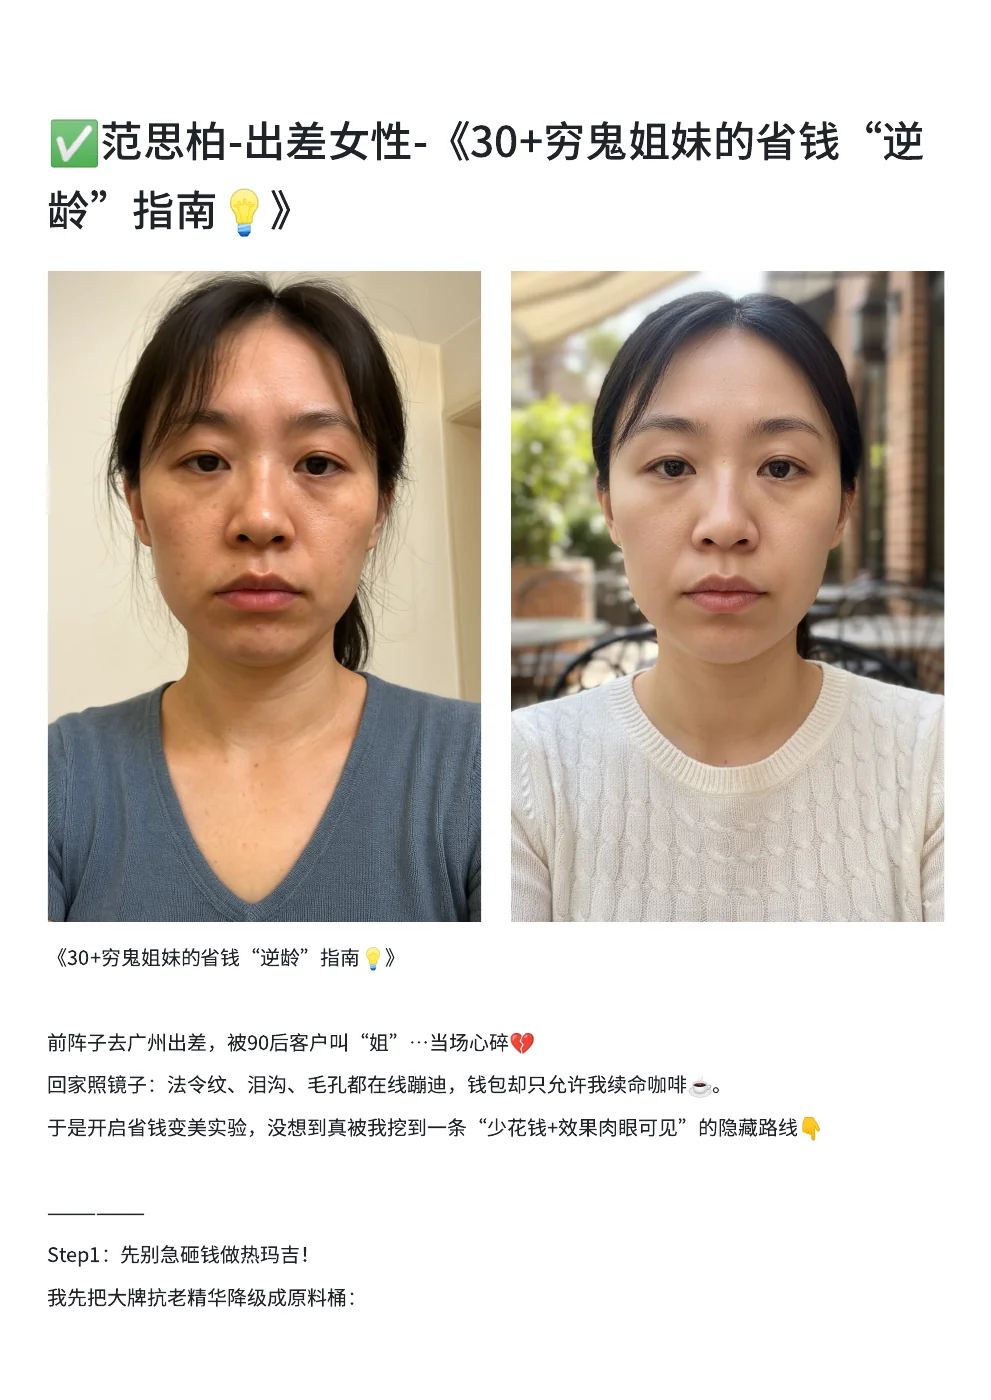
如果现在继续做,我会把“场景化表达”和“事实来源”拆开管理。人物视角可以帮助组织语言,真实经历和效果描述则需要真实资料支撑;生成样稿也应该有清楚的身份。
下面是按这个思路整理的参考提示词,同样属于本次补写的模板。
查看提示词:小红书软文
## 角色
- 你是一个小红书营销文案大师,擅长根据生成要求,写出用于触达医美用户的营销文案

## 背景:
- 优秀的爆款文案是我冷启动非常重要的环节,如果再写不出爆款我就要被领导裁员了,我希望你能引起重视。
- 我希望能够在小红书上发布一些文章,能够吸引大家的关注,拥有更多流量。但是我自己并不擅长小红书内容创作,你需要根据我给定的产品信息结合文章思路、生成要求,设计出爆款文案。

## 产品信息
- [{'产品名称': '范思柏', '生产厂家': '华熙生物', '产品成分': '微交联透明质酸钠、利多卡因', '产品特点': '* 低粘弹性、小粒径微交联 HA,兼顾柔软度与支撑力  * HEC 高效微交联技术,三维网状结构,低交联剂用量、高有效交联度  * 24 h “三态”利多卡因缓释,注射即缓解疼痛并持续镇痛  * 中性 pH 配方,刺激性低', '市场定位': '专注静态纹及面部抗衰的真皮微填充产品,主打“安全、舒适、见效快”', '产品功效': '平滑细纹、紧致提升、隐匿毛孔、增强皮肤屏障、补水润泽', '使用部位': '面部真皮层(PPT 标注“全面部肌肤焕活”)', '治疗方法': '真皮层微交联透明质酸钠注射(微填充方式),单次疗效3–6 个月,建议按个体衰老程度 6 个月左右维护 1 次', '技术要点': 'HEC 高效微交联、四项专利制粒/交联工艺、BD Hypak PRTC 预灌封注射器', '使用人群': '想改善静态皱纹、整体松弛及干纹的成年求美者'}]
- 产品作用部位:[面部]

## 文章思路
- 思路集合:["极简医美思路","不动刀变美思路","长期主义变美思路","省钱变美思路","普通人变美思路","皮贴骨思路","上镜脸医美思路","韩女变美思路","明星同款变美思路","妈生脸医美思路","幼态脸变美思路","肉肉脸变美思路","方圆脸变美思路","长中庭变美思路","面部年轻化思路","大小脸变美思路","做减法变美思路","讲故事变美思路"]

## 生成要求
- 以让用户看不出是推销的角度,潜移默化顺理成章的带出产品
- 内容中穿插 emoji 表情
- 直接生成文字内容中不要包含 markdown 语法
- 先结合产品类型,再考虑写文章的思路,从「思路集合」中随机一种或者几种,先确认思路再生成文案
- 标题在25字以内,制造悬疑,标题对于吸引用户点进来查看非常重要!
   + 写标题时,需要使用到爆款关键词 :
      绝绝子,停止摆烂,压箱底,建议收藏,好用到哭,大数据,教科书般,小白必看,宝藏, 绝绝子, 神器, 都给我冲, 划重点, 笑不活了,YYDS,秘方, 我不允许, 压箱底, 建议收藏, 停止摆烂, 上天在提醒你, 挑战全网, 手把手, 揭秘, 普通女生, 沉浸式, 有手就能做, 吹爆, 好用哭了, 搞钱必看, 狠狠搞钱, 打工人, 吐血整理, 家人们, 隐藏, 高级感, 治愈, 破防了, 万万没想到, 爆款, 永远可以相信, 被夸爆, 手残党必备, 正确姿势, 疯狂点赞, 超有料, 到我碗里来, 小确幸, 老板娘哭了, 懂得都懂, 欲罢不能, 老司机 剁手清单, 无敌, 指南, 拯救,  闺蜜推荐,  一百分, 亲测, 良心推荐,独家,尝鲜,小窍门,人人必备
- 正文要求
   + 正文中不要输出 #标签
   + 正文在 500 字以上
   + 针对大段文本进行适当换行,保证阅读体验;
七、客户评价图
这一块当时直接改开源项目,没有太多技术,就不展开了。
把当时调研的几个入口留在这里,按需参考:
- Gitee:lifeixue/weixin-chat
- GitHub:zixiwangluo/wxdh
- GitHub:shidudu2022/weixinduihua
- 在线参考:微信对话生成器
- 在线参考:微截图 Pro
这些是当时的调研清单,酌情使用吧。
八、做完之后,我更在意素材能不能接着用
回头看,这个项目最费精力的地方,是把很多小环节接起来。
一种案例有几种拍法,一个产品有几种讲法,脚本上的“三至五”怎么读,照片用什么姿势,音频有问题退回哪一步,剪辑完成后由谁确认……需求拆开看都不大,做成一套东西,工作量就出来了。
我现在会更在意几件事:同一个产品的不同素材,事实能不能对得上;人物和图片有没有记录,后面能不能复用;机构人员拿到之后,知不知道该发在哪里、怎么接着解释。
这里也会反过来约束生成能力的用法。案例图越像真实照片,越需要讲清楚它是示意;客户反馈越能影响决策,越需要有真实来源。素材得让人愿意看,也得经得起追问。
模型负责生成,PM 还得继续琢磨:哪些内容值得生成,怎么组合,交给谁用,用完之后又能拿到什么反馈。